Helix 2.5:零样本进30家,整任务成功率从9%拉到56%
一、零样本钉在评测房和被操作物体上
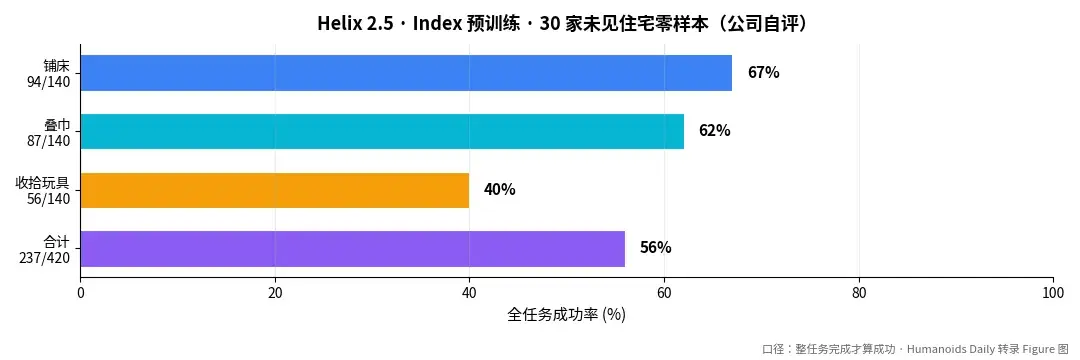
人形走进没见过的住宅立刻干活,Figure 在2026年9月17日交出一组硬数字:Helix 2.5 进入30套未见湾区住宅,Index 预训练把全任务零样本成功从9%拉到56%,约6倍。Humanoids Daily 把官方柱图转录成试次——铺床94/140=67%、叠巾87/140=62%、收拾玩具56/140=40%,合计237/420≈56%。The AI Insider 交叉转述同一套对照。成功只认整任务完成,不给部分分。Brett Adcock 说评测房是租来的;他和 AI 主管 Corey Lynch 称30家每家都有成功,覆盖面到了,试次成功率仍是56%。
Helix 02 已经能协调人形全身长程动作,从卸洗碗机到物流任务连续自主约200小时,那些系统是在机器人将要作业的场地采数学会的。Helix 2.5 把问题改硬:走进从没见过的家,立刻用全身自己干活。单一 Index 预训练基座拉出三套全身行为:收拾客厅玩具、叠毛巾、铺床,把走路、抓硬物、叠软物、双手配合和边走边看绑进同一套策略。桌面臂有固定工作空间,轮式底盘要够转身;住宅不给人让路,人形必须把移动、换姿、伸手揉进同一段控制。评测房与被操作物体按零样本执行:无采数、无微调、无现场适应;评测玩具、毛巾、床品不进 task-specification 数据,现成沙发、床和叠巾台直接用。任务本身已在他处用 task-specification 数据学过。零样本钉的是环境和物体,行为靠场外任务指定数据学会。评测物体实验前隔离,先过模型筛再人工核对。每项任务共用一个固定 checkpoint 跑完30家,评测 rollout 和成绩不参与选点。客厅要把散落的13–15件玩具全部入筐;叠巾要把毛巾全部折好入筐,Humanoids Daily 记每试次四条;铺床要把两个枕头和被子四角放到床头三分之一,被子拉平。安全介入记失败;玩具单件超时1分钟、毛巾3分钟、枕头与被角1分钟,超时同样失败。Adcock 称 Helix 2.5 是 Figure 做过最重要的项目,并放出近四小时加长影像。Humanoids Daily 提醒,加长片不是420次评测的完整底稿。公司自称,就该范围而言,这是人形上首次全身零样本泛化展示。
二、Index 对照:9%到56%,任务数据减半
两条策略吃同一份不含评测房和评测物体的任务数据。一条随机初始化,一条从 Index 预训练的 Helix 2.5 起步;架构、优化、超参、下游数据和评测全部固定,唯一变量是 Index 预训练。盲测里从零训练的策略全任务零样本成功9%,Index 预训练策略56%,约6倍。Helix 2.5 自身从随机初始化、纯 Index 预训练;Helix 02 从预训练 VLM 起步。任一评测任务在 Index 预训练中占比不超过1.90%,预训练按公司说法刻意铺得很宽,好接后续行为微调。相对 Helix 02 同类行为,task-specific 数据大约减半,部署范围扩到30×未见环境,Figure 口径是「2x cheaper / 30x scope」。Helix 02 在评测环境里直接采数;Helix 2.5 用一半适应数据对齐成功率,再零样本铺到30家。长程里出现可观察的全身自纠:后退换位、改站姿、绕床去修一处折痕。该对照把泛化增量主要记在 Index 预训练上:同一份任务数据从广谱人经验起步,搬到新房子里更有效。
三、人→人形 transfer:8×数据上的可预报 loss
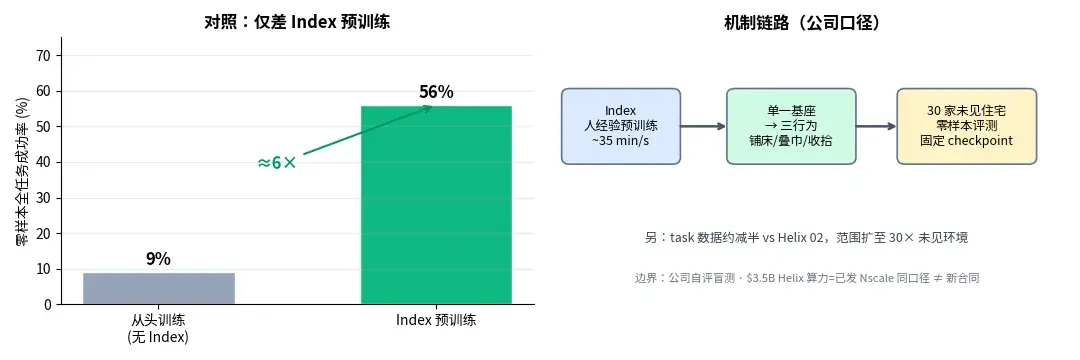
Figure 把语言模型那套小跑预报大跑接到人形。四个固定规模模型,在 Index 嵌套子集上跨8×预训练数据,下游任务数据和训练固定,测留出动作预测 loss。每翻倍一次,loss 平滑下降。公司自称这是人形上测到的第一条人→机器人 transfer scaling law。只用小跑,最大跑测试 loss 预报到四位小数,预报误差为全区间变异的0.54%。该曲线钉的是预测 loss,模型规模固定,不等于实机成功率同斜率。Index 现约每秒35分钟新人经验上传,这是本条官博口径;Lynch 视频另报每周逾9万人贡献,仍是公司自报。吞吐本身不证明下一批数据的质量和多样性。八月 Index 公开时,每千小时大约含373种任务、1146种物体、116种环境,那是当时的多样性快照。后续观察点要落到质量和覆盖能不能撑起下一轮翻倍。
四、公司自评、$3.5B 同口径、将近一半失败
这组数字是公司自评盲测。Humanoids Daily 和 The AI Insider 做交叉转述,尚未出现独立实验室复现。官博柱图基线约35/420≈8.3%,正文写成9%,已发表材料里有一处小差额,主对照仍以官文9%→56%为准。Sunday Robotics 的 Tony Zhao 把237/420读成「一半失败」,并写 useful work = generalization + reliability。整任务失败率约44%;失败不等于全程零进展。Sunday 的 ACT-2 报778/785件衣物折叠(99.1%),计量单位是单件衣物尝试;Helix 2.5 的56%是整床、整筐玩具、整组毛巾的长程试次,物件、时长和评分规则都不同,不能拿来排座次。官博写 committed $3.5B compute to training Helix,与已公开的 Figure×Nscale Vera Rubin 算力承诺同口径复述,不是9月17日新签的算力合同,也不是新一轮融资。算力跑道背景止于此。Figure 仍是私营主体,没有可映射的上市证券。
五、家评扩容、Index 质量、成功率相对56%的抬升
这套9%→56%的对照把产业问题推到数据配方:广谱人经验预训练,行为用一份任务数据指定,部署时不再按房间重建。家用人形的门槛从熟悉场地挪到陌生房子里整段做完。下一催化剂可以顺着几条观察指标看。下一版 Helix 是否仍用同一套 Index 基座扩任务。家评能否从30套湾区租房扩到湾区以外、业主在场、被打断的家务和跨日重复。Index 每秒35分钟的质量和任务、物体、环境多样性,比单纯涨吞吐更关键。全任务成功率相对56%能否抬到可当服务的阈值——收拾玩具仍是40%,三任务里最弱;44%整任务失败在商业上门场景里站不住。已承诺的 Helix 训练算力何时真正转化成更高零样本可靠度,要看后续评测;本条仍是已公开算力承诺的同口径复述。若8×子集上的 loss 规律继续,数据再翻倍可能压低动作预测误差;实机成功率会不会跟着走,Helix 2.5 没有给出同斜率证明。
六、证据在泛化,服务还差可靠度
Helix 2.5 给出的是公司口径下、30套未见住宅上的全身零样本证据:Index 预训练把9%拉到56%,铺床67%、叠巾62%、收拾40%。Figure 自己写明,通用人形机器人并未解决。租房评测、固定三任务、湾区样本,都还不是日常住户的占用房间。56%是研究台阶,不是上门服务的 SLA。下一拍看家评外扩、Index 数据质量,以及成功率相对56%还能抬多少。