TypeSafe Jev:一个只做决策、不写字的模型,把自动化里的「解析税」砍掉
一、聊天模型很强,自动化却还卡在「写字要解析」
过去两年大模型的进步几乎都发生在「说话」这件事上:写代码、写文案、多轮对话,越来越像人。可一旦把它塞进真正的自动化流水线,工程师面对的仍是老问题:模型给的是一段字符串,程序要的是一个可以直接分支的值。你让它判断「这张工单是不是退款问题」,它回你一段带解释的文字,你得写正则、加 JSON Schema、再加重试兜底,最后还要防着它某天突然多说一句话把解析器打崩。这层「解析税」远不止几行胶水代码,它把时延拉到秒级,把成本按输出 token 计价,把可靠性交给一种概率很低但迟早会出现的格式漂移。工具调用和结构化输出缓解了一部分,底层机制却没变:模型仍在逐 token 生成文本,只是被约束得更紧。2026 年 9 月 15 日,TypeSafe 在博客上给出另一条路:推出名为 System One 的模型类别和第一款公开模型 Jev,以 early access 形式开放。创始人 Diogo Almeida 对它的概括很直接:一次 frontier-intelligence 级别的函数调用,非结构化状态进,类型化的概率决策出,从头到尾不生成字符串。
二、System One 为什么不写字:RLCD 与一次并行作答
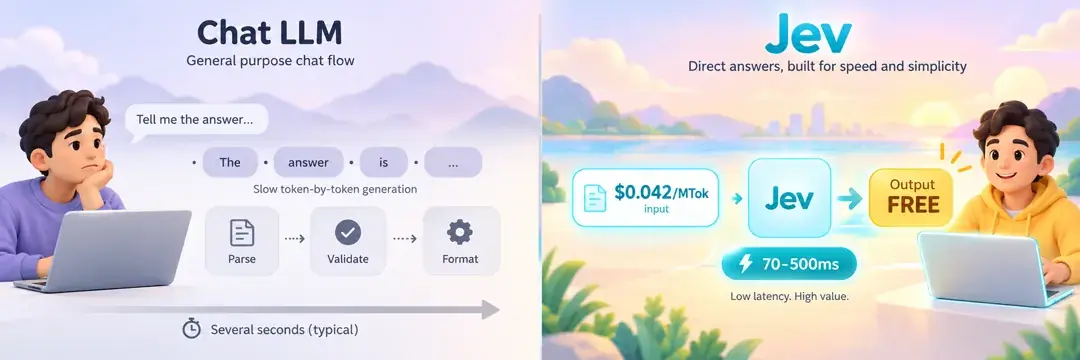
System One 这个名字取自 Kahneman 对快思考系统的称呼,Jev 则致敬经济学家 Jevons,两个名字合起来大致说明了它想干什么:便宜、快、可靠地做大量小决策,把慢思考和长篇表达留给别的模型。它在接口层面放弃了自由文本输出,换来两样东西:类型安全,以及一种「无法幻觉」的决策 I/O。这里的无法幻觉指的是返回值只能落在你事先定义的类型空间里,判断对错另当别论,但它绝不会编造出一个不存在的选项,也不会让输出格式跑偏。训练方法上,TypeSafe 提出 RLCD,即 Reinforcement Learning for Calibrated Decisions,面向校准决策的强化学习。对照人们熟悉的 RLHF 以人类偏好为信号、RLVR 以可验证结果为信号,RLCD 的优化目标是让模型报出的概率与真实正确率对齐:它说 0.9 的事情,应当大约有九成确实为真。校准在聊天场景里是锦上添花,在自动化里却是能否设阈值、能否决定「多少置信度以下转人工」的生命线。采样方式也随之改变。普通 LLM 逐 token 自回归,答案越长越慢;Jev 把一次请求里的所有 questions 并行一次性答完,没有逐字吐出的过程。这是它时延能压到几十到几百毫秒量级的结构性原因,也解释了输出为何可以免费:它根本没有多少输出 token 可计。
三、三种原语与校准概率:Choice、Score、Boolean
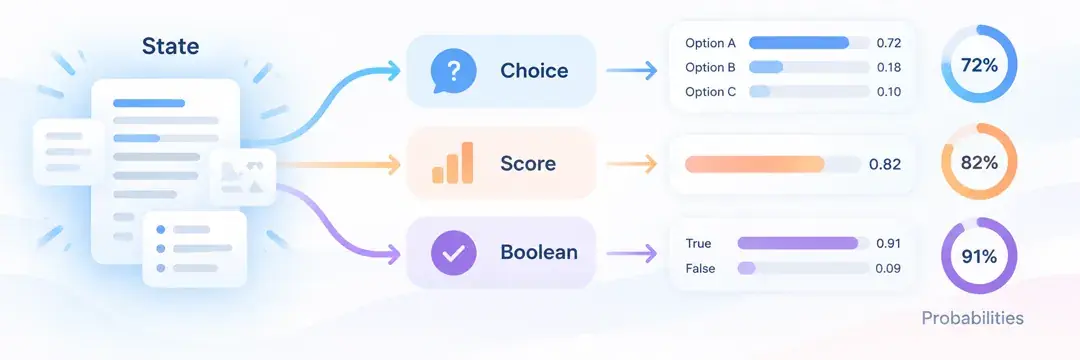
Jev 的输入分两部分:一段任意形式的 state,可以是工单正文、对话记录、日志片段或拼接起来的上下文;再加一组带类型的 questions。输出严格对应每个问题的类型,只有三种原语。Choice 用于多选一,你给出候选项,它返回被选中的项、在全部选项上的概率分布以及一个总体 confidence。Score 用于打分,你定义量表范围,它返回各刻度上的分布和置信度,适合质量评估、优先级排序这类需要连续判断的场景。第三种在 TypeSafe 自己的文档里叫 Noul,是一个 P(true) 落在 [0,1] 区间的真值判断;Vercel AI Gateway 和 AI SDK 侧统一称为 boolean,两个名字指的是同一件事,后文按 SDK 习惯用 boolean。
这套设计真正要紧的地方是每一个返回值都自带概率。传统做法里模型说「是」,你不知道它有多确定;Jev 返回 0.93 和 0.55 是两种截然不同的信号,前者可以直接自动放行,后者应当触发复核。同一次请求可以塞进多个问题,它们并行作答、共享同一份 state,一份工单进去,「是否涉及退款」「紧急程度几分」「该走哪条队伍」三个答案同时出来,工程上不必再拆成三次调用,也不必拼一个巨大的 JSON Schema 去赌模型能否填对每个字段。
四、定价、时延与 Gateway 上手:先 boolean,再 choice
价格是 Jev 最容易被记住的部分:输入 $0.042 每百万 token,折算成每十亿 token 是 42 美元;输出完全免费。端到端时延官方给的区间是 70 到 500 毫秒,取决于 state 长度和问题数量。官网页面引用的 workflow evals 高位对比宣称,相对基于 LLM wrapper 的实现最多可快约 193.6 倍、便宜约 444.6 倍。这两个数字出自特定 workflow 评测的偏高实绩,换成你自己的任务通常不会这么夸张,把它当成「量级差距真实存在」的信号即可,别当成可写进合同的普适 SLA。完整对照表放在 evals.typesafe.ai,按 workflow 与 prompt 两种做法分列。
分发方面,2026 年 9 月 16 日 Jev 上线 Vercel AI Gateway,模型标识为 `typesafe-ai/jev`,配套 AI SDK 7 从 7.0.105 起提供 `experimental_evaluate` 接口,可按需开启 Zero Data Retention。不想经 Gateway 也可以直连原生 API:向 `https://api.typesafe.ai/v1/systemone` 发 POST,model 填 `jev-latest`。上手最短路径是一个 boolean 问题。调用 `evaluate`,传入 model 为 `typesafe-ai/jev`,state 写一句「客服已全额退款」,questions 里放一个键叫 `refunded` 的问题,type 设为 `boolean`,instructions 写「是否已退款?」。返回的 `answers.refunded.probability` 就是它认为为真的概率,一个 0 到 1 的浮点数,拿它跟阈值比一下就能分支,整个过程没有任何字符串需要解析。第二步升级到 choice 做路由。在 questions 里加一个 `route`,type 设为 `choice`,instructions 写「路由工单」,criteria 用一个对象列出候选项和各自的说明:`billing` 对应支付退款、`shipping` 对应物流、`technical` 对应故障。返回里 `choice` 是被选中的键,`probabilities` 是三个选项各自的概率。实践中最有价值的恰恰是那个分布本身:如果最高项只有 0.4,另外两项各 0.3,说明这张工单本身就模糊,直接丢给人工复核比硬派到某个队伍更划算。校准过的概率让「不确定就转人工」从一句口号变成一行可执行的条件判断。
五、适合什么,不适合什么
把 Jev 放进现有系统的合理位置,是所有需要「在极短时间内做一个小判断」的节点。工单和消息路由、内容或线索打分、安全护栏与合规预检、实时流程中的条件分支,以及 agent 每一步之后决定「继续、重试、升级还是停止」,这些场景的共同点是决策空间有限、对时延敏感、调用频次极高,恰好落在它 70 到 500 毫秒和输出免费的舒适区。多智能体编排里它尤其顺手:主模型负责生成和推理,Jev 负责在每个交接点做快速裁决,用一次几十毫秒的 boolean 判断替代一次数秒的完整推理调用,成本和时延都能压下一个量级。边界也很清楚。它不做长对话,不写长文,不生成代码,不会解释「为什么这么判断」,任何需要自由文本输出的任务都不属于它的领域。类型空间必须由你事先定义,选项定义得含糊,返回的概率分布也只会跟着含糊。该模型目前还处在 early access,Gateway 上的 `experimental_evaluate` 接口带着 experimental 前缀,接口形态在正式版之前有变动的可能,生产环境接入时留一层薄封装是稳妥做法。
六、克制地看接下来几个月
Jev 最值得记住的地方,是它把一个长期被当成 prompt 技巧的问题——如何让模型输出可被程序直接消费——变成了模型本身的输出类型。这条路能走多远,接下来几个方向最值得盯。一是 early access 的扩容速度,当前的时延和价格是在有限用户下测得的,规模上来之后跨区域的 p50 和 p99 能否守住 70 到 500 毫秒区间,是它能否进入实时链路的前提。二是 Gateway 和 `experimental_evaluate` 何时摘掉 experimental,接口稳定下来才会有团队愿意把它写进核心路径。三是社区里 workflow 模式会不会扩散,evals.typesafe.ai 目前对照的是 TypeSafe 自己设计的任务,在第三方复现和不同领域的独立评测出来之前,193.6 倍和 444.6 倍应当继续被当成偏高实绩看待。四是 $0.042 每百万 token 输入、输出免费的定价能否长期站得住,对一家早期私营公司来说,这个价位既是获客手段也是成本承诺。对使用者而言,眼下最合理的做法是挑一个已经在跑的路由或护栏节点,用 boolean 或 choice 替换现有的「让 LLM 输出 JSON 再解析」方案,对比一周的真实时延、错判率和账单,再决定要不要把更多决策交给它。