48 小时三家齐发:GPT-6 Sol/Luna 补齐梯队,横向对照 Opus 5.5 与 Grok 4.7 的价位与角色
一、同一条天花板下的三种调价
美东时间 9 月 21 日至 22 日约 48 小时里,xAI、OpenAI、Anthropic 的新模型相继上架 API,每百万输入 token 的标价从 GPT-6 Luna 的 $0.10,到 GPT-6 Sol 与 Grok 4.7 并列的 $2,再到 Claude Opus 5.5 的 $4,两端相差 40 倍。缓存读取一栏却换了次序,Sol 与 Opus 5.5 同为 $0.20,Grok 4.7 是 $0.50;按九成输入命中缓存折算,Opus 5.5 的有效输入价反而比 Grok 4.7 低约一成。
xAI(现以 SpaceXAI 品牌发布)9 月 21 日先推出 Grok 4.7,API 名 `grok-4.7`,每百万 token 输入 $2、输出 $6,与 Grok 4.6 同价同速。22 日,OpenAI 在旗舰 GPT-6 Astra 之下补齐 Sol(`gpt-6-sol`)与 Luna(`gpt-6-luna`)两档,Anthropic 同日发布 Claude 5.5 家族首款 Opus 5.5(`claude-opus-5-5`)。
三家的调价方向各不相同。OpenAI 把 Sol 从 GPT-5.6 Sol 的宣传价 $4/$20 砍到 $2/$10,降幅 50%;Luna 从 $0.20/$1.20 降到 $0.10/$0.50,输入减半,输出降约 58%。Anthropic 把 Opus 标价从 Opus 5 的 $5/$25 下调两成,缓存读取从 $0.50 降到 $0.20,降幅六成,并称典型工作负载总成本约低 40%、输出速度快 30% 以上。xAI 价格不动,升级放在能力上。
这三种动作都落在同一条天花板之下。GPT-6 Astra 与 Claude Fable 5.1 的标价都停在 $10/$50,这 48 小时的交锋集中在 $0.10 到 $4 的输入区间。Opus 5.5 的新价正好等于 GPT-5.6 Sol 的宣传价,GPT-6 Sol 又在这个位置上往下让了一半。
二、标价、缓存与长上下文三把尺
按基础标价排,输入端依次是 Luna $0.10、Sol 与 Grok 4.7 各 $2、Opus 5.5 $4,输出端依次是 Luna $0.50、Grok 4.7 $6、Sol $10、Opus 5.5 $20。OpenAI 与 Anthropic 的输出价都是输入价的 5 倍,Grok 4.7 只有 3 倍,同样 $2 的输入,它的输出比 Sol 便宜四成,大段生成代码或长文档的任务直接受益。Sol 的输入、输出和缓存三项单价都正好是 Luna 的 20 倍,Opus 5.5 的输入和输出都是 Sol 的 2 倍。
缓存读取改写了这张表。OpenAI 两档的缓存价是输入价的一成,Opus 5.5 是 5%,Grok 4.7 是 25%。假设九成输入命中缓存、暂不计缓存写入,每百万输入 token 的有效价格约为 Sol $0.38、Opus 5.5 $0.58、Grok 4.7 $0.65,Luna 不到 $0.02。在这一假设下,Opus 5.5 与 Sol 的输入侧差距从标价的 2 倍收窄到约 1.5 倍,输出侧仍是 2 倍;Grok 4.7 相对 Opus 5.5 的价格优势只剩输出一栏,$6 对 $20,便宜七成。
长上下文是第三把尺。Sol 与 Luna 的窗口都是 1.05M,单次输入超过 272K token,整单的输入与缓存按 2 倍、输出按 1.5 倍计费,Sol 的输入、缓存、输出变成 $4、$0.40、$15,Luna 变成 $0.20、$0.02、$0.75。整单结算会制造断崖,按未命中缓存计,一次 27 万 token 的请求输入费约 $0.54,多 1 万 token 越过阈值就变成 $1.12。Grok 4.7 的窗口为 500K,门槛更低,提示词达到 200K token 即整单升到输入 $4、缓存 $1、输出 $12。越过各自门槛后,Sol 与 Grok 4.7 的输入单价都是 $4,与窗口 1M 的 Opus 5.5 基础输入价持平,缓存读价 $0.40 和 $1 都高过 Opus 5.5 基础价里的 $0.20。
速度也被做成加价项。OpenAI 的 Batch 与 Flex 半价,Sol 折合 $1/$5;Fast 档按 2 倍计,折合 $4/$20,与 Opus 5.5 的标准价相同。Opus 5.5 的 Fast mode 为 $8/$40,官方称速度最高约 2.5 倍。Grok 4.7 的快速变体同样以两倍价格换两倍输出速度,只在 Cursor 与 Grok Build 里提供,公有 API 调不到。
三、量产、工作马、同价编码、旗舰代理四种角色
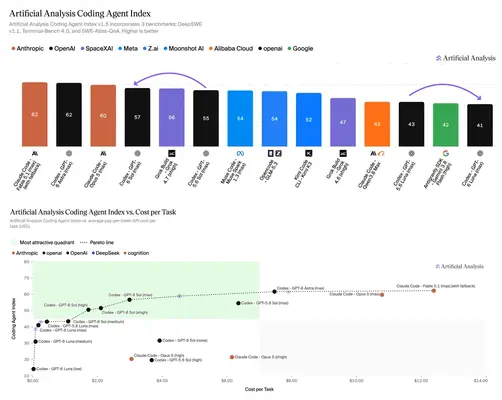
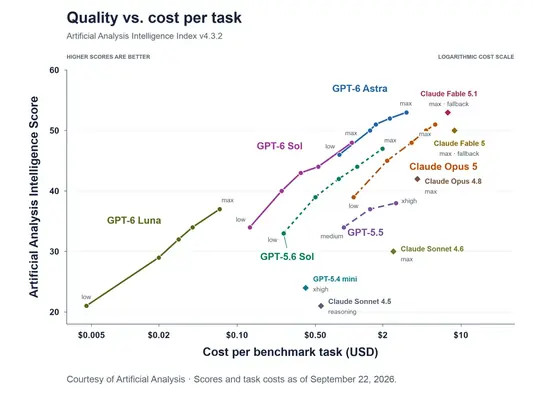
Luna 对应高量廉价这一格。$0.10/$0.50 加 $0.01 的缓存价,适合分类、抽取、摘要、路由和批量子代理;Artificial Analysis(下称 AA)测得它在智能指数(Intelligence Index)上的每任务成本约 $0.07,比上一代约 $0.18 低六成。它的编码代理指数(Coding Agent Index)为 41,比前代低 2 分,AA-Omniscience 幻觉率从 93% 降到 77%,仍然偏高。Luna 的用武之地因此是结果能被下游规则校验的流水线。
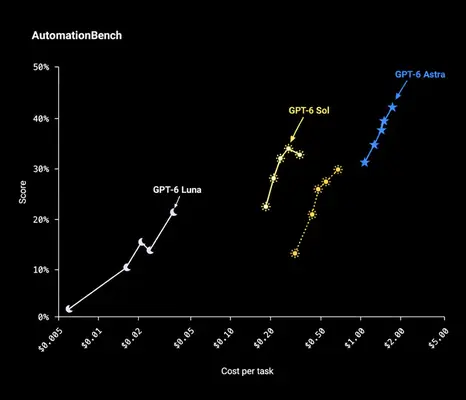
Sol 是 OpenAI 这一代的工作马。AA 测得它 max 档在智能指数上的每任务成本约 $1.06,约为 GPT-5.6 Sol $1.99 的一半;编码代理指数 57,比前代高 2 分,处在得分与成本的帕累托前沿。OpenAI 自测的事实差错约减半,AA 测得的幻觉率从 92% 降到 60%,两边方向一致。短板落在 GDPval-AA 这类要交付文档、表格和幻灯片的知识工作上,Sol 较前代回落约 100 Elo,AA 的归因是交付变短、漏掉评分细则的要求。它适合编码与多步代理循环,长篇成品仍需人工验收。
Grok 4.7 与 Sol 同处 $2 输入价位,主打编码与知识工作。xAI 表中它的 CursorBench 4.0 为 46.3%,DeepSWE v1.1 为 71.0%(取 high 档并加注星标,同表 GPT-5.6 Sol Max 为 72.7%),电气工程 EEBench 为 64.0%,领先同表各家。AA 给它配自家 Grok Build 测出的编码代理指数为 56,比 4.6 高 9 分,GDPval-AA 涨 90 分到 1695。代价在用量上,xhigh 档每个智能指数任务约输出 8.1 万 token,是 Grok 4.6 xhigh 的两倍多,GPT-6 Astra max 只用 2.7 万。输出单价低四成的优势,要先扣掉这部分用量。
Opus 5.5 占旗舰代理这一格。Anthropic 称它在多数工作上达到 Fable 5.1 的水平,自适应 max 档下 Terminal-Bench 4.0 为 66.4%,FrontierCode 为 54.4%,GDPval-AA v2.1 为 1846 Elo,Zapier 的 AutomationBench 为 40.0%;同表中标价 $10/$50 的 GPT-6 Astra 依次为 57.9%、53.3%、1542 和 41.4%。标价只降两成,典型负载却省四成,中间的差额要靠缓存读价下调和更少的 token 消耗来补。该档适合失败代价高的长程代理、终端操作和成品交付,$20 的输出价要靠减少返工才划算。
四、官方图表对照的多是上一代,锚点与 AA 补上同一把尺
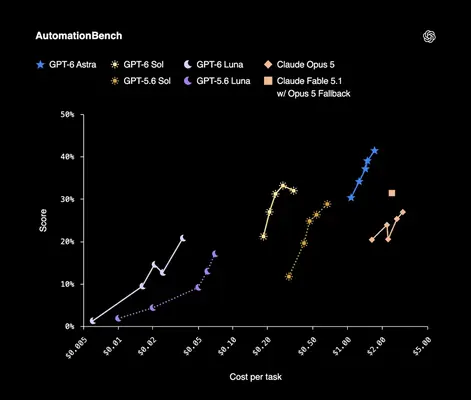
三家官方图表里,拿来对照的 Opus 与 Sol 都还是上一代。OpenAI 的 AutomationBench 图里,Sol 在 xhigh 档得 33.2%,每任务约 $0.27,对照的 Claude 是 Opus 5 max,得分 26.9%,任务成本约为 Sol 的 11.1 倍,折算下来 Sol 约为它的 9%,图里没有 Opus 5.5。xAI 表发得更早,对照的是 GPT-5.6 Sol Max 与 Fable 5.1 Max。Anthropic 表放进了 GPT-6 Astra,Sol 一栏仍是 GPT-5.6 Sol。
这三份图表之间有两处可以对齐的锚点。AutomationBench 上,OpenAI 与 Anthropic 给 Opus 5 的分数都是 26.9%,按这一共同刻度粗看,Opus 5.5 的 40.0% 比 Sol xhigh 的 33.2% 高约 7 个点。该比较有两处限定,Sol 这项没有用上更高的 max 档,Anthropic 则把安全护栏的干预记为失败。成本一侧,9% 是对 Opus 5 算的,换成 Opus 5.5,分数和成本两头都在变。
CursorBench 4.0 是第二处锚点。xAI 与 Anthropic 两张表给 Fable 5.1 的都是 51.8%,给 GPT-5.6 Sol 的都是 41.7%。放在同一刻度上,Opus 5.5 的 57.8% 比 Grok 4.7 的 46.3% 高 11.5 个点,Grok 4.7 与 Opus 5 的 46.6% 基本持平。两边推理档位不同,Opus 5.5 为自适应 max,Grok 4.7 为 xHigh,GPT-6 Sol 也不在这两张表里。
AA 的编码代理指数用同一组任务,让每个模型跑在自家原生的编码代理环境里。9 月 21 日 Grok 4.7 配 Grok Build 以 56 分越过 GPT-5.6 Sol,次日 GPT-6 Sol 拿到 57 分,领先一分。知识工作一侧方向相反,GDPval-AA 上 Grok 4.7 较前代涨约 90 分,Sol 与 Luna 分别回落约 100 分和 75 分;Anthropic 表在这一项给 GPT-5.6 Sol 的分数是 1588,Opus 5.5 的 1846 同样出自该表。
这组对照拼出的格局是,$2 价位上 Sol 与 Grok 4.7 的编码代理能力几乎打平,交付型知识工作的走向相反;Opus 5.5 在 Anthropic 表里的 Terminal-Bench 4.0、代码与 GDPval-AA 分数领先,还缺一张与 Sol、Grok 4.7 同条件跑出的成绩单。
五、ChatGPT 与 Codex 先行,Foundry 同日上架,Opus 5.5 三云首发
Sol 与 Luna 先进入 ChatGPT Work 和 Codex,覆盖 Plus、Pro、Business、Enterprise 与 Edu;Free 与 Go 用户在桌面端可以用 Luna,普通 Chat 主界面尚未切换,按逐步放量推进。微软同日在 Microsoft Foundry 上架 Astra、Sol、Luna 三档,面向生产级代理。
Opus 5.5 发布即覆盖 Claude 应用与 API,以及 AWS、Google Cloud 和 Microsoft Azure,Pro、Max、Team、Enterprise 订阅的 5 小时用量上限同步提高。Azure 客户由此在同一天拿到了两家的新品,Foundry 上 GPT-6 三档与 Opus 5.5 可以并排调用。
Grok 4.7 的首日渠道集中在开发者入口。标准版走 xAI API,Vercel AI Gateway 与 OpenRouter 当天上架,Vercel 到 9 月 27 日前减价四成,折合 $1.20/$3.60;快速变体只在 Cursor 与 Grok Build 内提供。三家首发的重心因此各不相同,OpenAI 押自家产品与 Azure,Anthropic 首日铺满三朵云,xAI 从开发者入口切入,各价位带的真实用量会先在这些入口里分出高下。
六、接下来几周的观察点
Anthropic 的下一步最先揭晓。Sonnet 5.5 与 Haiku 5.5 已排在未来数周,眼下 Claude 5.5 家族只有 Opus 一档,$2 与 $0.10 两个价位上还没有它的新品,xAI 的 CursorBench 成本图里 Anthropic 中档的对照仍是 Sonnet 5。两款新品的标价,以及缓存读取是否同样按输入价的 5% 计,决定 $2 价位会不会从两家变成三家。
AA 的 GDPval-AA 是否回摆,是检验 Sol 与 Luna 降价成色的指标。两者的失分与交付长度直接相关,OpenAI 后续快照或默认设置若有调整,AA 重测是最直接的验证;Opus 5.5 的 1846 要与 Sol 的新分数放进 AA 同一版本里并排,才能读出两档在交付型任务上的真实差距。
长上下文溢价与缓存命中,要在真实代理账单里兑现。带着整个代码库和工具轨迹运行的代理,很容易越过 Grok 4.7 的 200K 或 Sol 的 272K 门槛;OpenAI 称默认缓存命中率已经提高,GitHub 数月来需要重新处理的提示 token 占比降了一半以上。每任务的真实美元成本,要把上下文长度分布、命中率、重试率和每任务 token 数放在一起算,官方图表里 $0.27 一类的数字只是起点。
$2 价位的份额争夺会先在编码环境里见分晓。Sol 与 Grok 4.7 输入同价,编码代理指数只差 1 分;Grok 4.7 输出单价低四成,每任务输出量在 AA 的测量里偏高,Sol 的窗口更大、缓存更便宜,还握有 ChatGPT 与 Codex 入口。Vercel 促销 9 月 27 日到期后的路由价,以及两家在 Cursor、Codex 这类环境里的调用量,会先给出信号。
Opus 5.5 还有一道可用面约束。多数网络安全任务会被改派到 Opus 4.8,被标记的生物类请求回退到 Opus 5;网络安全验证计划将在未来数周扩容,生命科学验证计划已经开放。安全与生命科学客户实际调用到的是不是 Opus 5.5,要看验证名额推进的速度。
这 48 小时把梯子排出了四格,Luna 在底,Sol 与 Grok 4.7 并列 $2,Opus 5.5 在 $4。每一格能否守住,取决于缓存命中、长上下文门槛、每任务 token 和护栏回退落到账单上的结果,这些数字要到未来几周的真实代理负载里才看得清。