IonQ Superion 256 将成 NVAQC 首台现场 QPU:经 NVQLink 直连 GB200 NVL72,2027 年装机
一、一台尚未进场的“首台”
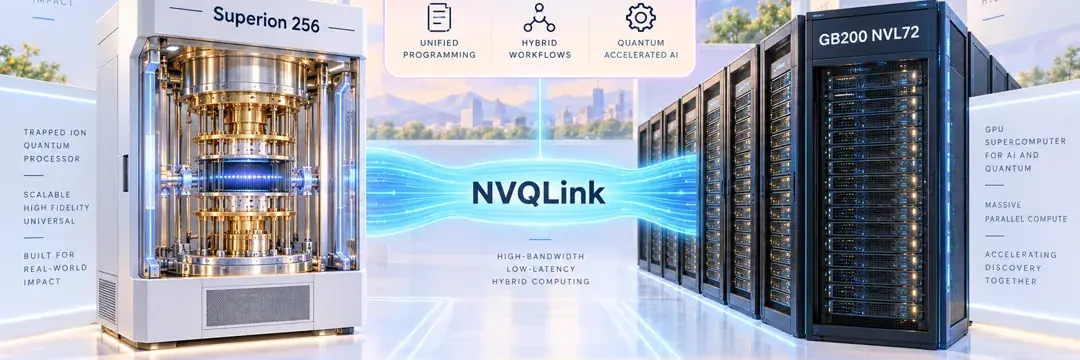
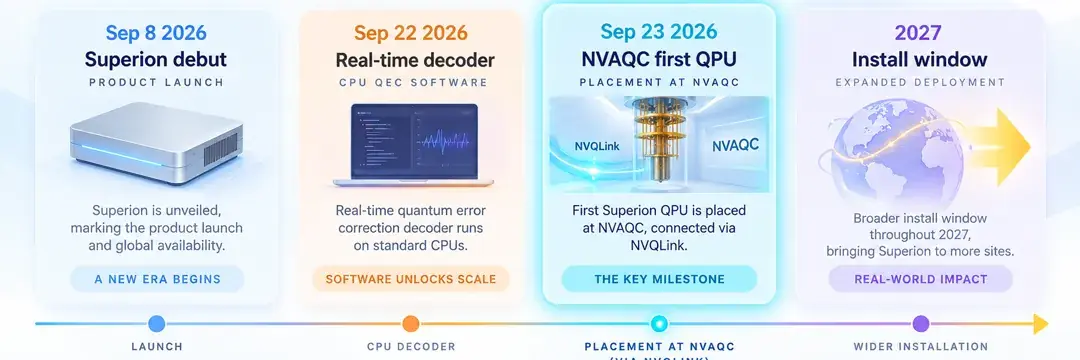
2026 年 9 月 23 日美东时间 08:00(EDT),IonQ(NYSE: IONQ)从马里兰州 College Park 经 Business Wire 发布通稿,宣布将 Superion 256 部署到 NVIDIA 加速量子研究中心(NVAQC)。按 IonQ 的口径,这台机器将成为 NVAQC 的首台现场(on-premise)量子处理器,通过 NVIDIA NVQLink 接入中心的 GB200 NVL72 系统,混合工作负载交给开放平台 CUDA-Q 编排。安装时间定在明年,也就是 2027 年。The Quantum Insider 当天的报道与通稿要点相互印证;截至成稿,路透、彭博和《华尔街日报》未见同日专稿,信息面仍以发行人通稿和行业媒体为主。
通稿没有披露合同金额,也没有给出订单金额或采购价格。能落到纸面上的,是一个“首台”身份、一条 Superion 256 经 NVQLink 连到 GB200 NVL72 的硬件链路,再加一个 2027 年的安装窗口,应用方向和研究产出都还停留在预期层面。
它的分量来自物理位置。过去几年,量子计算和 GPU 的结合多半走两条路,一条是经云端远程调用 QPU,另一条是在 GPU 上用 CUDA-Q 仿真量子线路。把真机搬进 GPU 超算机房、用专用互连直接接到 Blackwell 机柜上,这一步一直写在 NVAQC 的目标里;按 IonQ 的说法,此前还没有哪台 QPU 在中心现场落地。
二、NVQLink 管链路,CUDA-Q 管编排
这套混合栈可以拆成两层。底层是 NVQLink,NVIDIA 推出的开放互连架构,用来把量子控制系统和 GPU 超算接在一起。NVIDIA 产品页给出的规格是 GPU–QPU 吞吐最高约 400 Gb/s,FPGA–GPU–FPGA 往返延迟低于 4.0 μs,这里的 FPGA 通常对应量子控制电子学一侧。这组数字描述的是平台能力,并非 IonQ 的实测,Superion 256 接上后能跑到什么水平,要等 2027 年装机后的数据。
上层是 CUDA-Q,NVIDIA 的开放混合量子-经典编程平台。同一套代码既能在 GPU 仿真器上运行,也能下发到真实 QPU,混合作业里哪一段交给 QPU、哪一段留在 GPU、中间结果怎样回传,都由它来编排。IonQ 和 CUDA-Q 的配合也不是从零起步,本月在 IEEE Quantum Week 获奖的那项联合研究就跑在这个平台上。
另一端的 GB200 NVL72 是 NVAQC 的算力底座。按 NVIDIA 2025 年 3 月 18 日的博客与投资者关系公告,中心设在波士顿,配置 GB200 NVL72 与 Quantum-2 InfiniBand 网络,约 576 颗 Blackwell GPU 专用于量子研究。一台 QPU 背后挂着这种规模的 GPU 池,混合负载里的经典部分,比如预处理、参数优化、误差缓解和解码,都有充足算力承接。
这种直连跟云端调用、GPU 仿真相比,改变的是回路长度。云端访问要走公网、排队、按批次提交,一次往返常以秒乃至分钟计,经典和量子两边只能批处理式地交替;GPU 仿真适合先把算法跑通,可经典资源随比特数指数膨胀,规模上去以后绕不开真机。按 NVQLink 的规格,现场直连能把往返压到微秒量级,需要实时反馈的任务才有了落脚点,例如纠错解码、变分算法的参数快速迭代,以及线路中途测量后的即时调整。离子阱体系的比特相干时间较长,微秒级回路在纸面上有余量嵌进单次线路执行,能否兑现同样要看装机后的联调。
三、和本月另外两条公告分开读
IonQ 本月公告密集,几条消息容易混读。9 月 8 日是 Superion 256 的产品首发,重点在 SkyWater 制造的芯片、离子阱路线和开放下单,当时给出的首批客户交付预期是 2027 年。这次公告的题眼是这台机器放在哪里、跟谁相连——同款系统中的一台将进入 NVIDIA 的旗舰混合实验室,经 NVQLink 直连 GPU。NVAQC 的安装窗口同样落在 2027 年,和首发时的交付口径一致。
9 月 22 日公布的实时量子纠错解码器是另一条线,它在单颗商用 CPU 上运行、以 MegaQuOp 仿真验证,和这次的现场硬件部署没有直接关联。
两次发布相隔半个月,前一次回答这款机器能不能买到,这一次回答它会在谁的系统里运行。这层生态位置对 IonQ 分量不轻,它需要证明自家硬件能以加速器身份接入主流 GPU 超算,NVAQC 正是 NVIDIA 自己的旗舰测试场。
四、NVAQC 要的是共设计
NVAQC 于 2025 年 3 月宣布设立,当时点名的合作方包括 Quantinuum、QuEra、Quantum Machines,以及哈佛和 MIT。一年半之后,按 IonQ 的口径,第一台确定进场的现场 QPU 出自 IonQ 的离子阱路线。这一步会让中心从联合研究走到真机联调,此前能做的更多集中在软件栈、仿真和算法层面。
联合研究的重点有两块,一是混合软件开发,二是大规模系统原型。双方计划公开研究结果,并为未来的 AI 用例和量子-GPU 共设计提供指南。共设计指的是在设计阶段就把 QPU、互连、GPU 与软件的约束放在一起权衡——控制系统如何切分实时任务、GPU 侧的解码和优化器怎样匹配离子阱的操作时序,都属于这类问题。
应用上,通稿预期的方向集中在金融、材料和制药三块,具体是投资组合优化与风险管理、材料科学,以及药物发现中的计算化学。三者都是量子行业反复提到的候选场景,目前都还停在方向层面,量子优势的判断要等公开结果出来再说。
IonQ 与 NVIDIA 在软件层的合作已有先例。本月稍早的 IEEE Quantum Week 上,IonQ、NVIDIA、橡树岭国家实验室(Oak Ridge)与田纳西大学的联合研究获了奖。研究用生成式 AI 结合分布式量子算法求解组合优化问题,运行在 CUDA-Q 上。这项工作可以看作现场部署的前奏,算法和编排先在软件栈里验证,2027 年起再落到直连的真机上。
NVIDIA 量子业务副总裁兼总经理 Timothy Costa 在通稿中的表态是“Every supercomputer will become a quantum supercomputer.”(每一台超级计算机都将成为量子超级计算机)。这句话把 NVIDIA 的定位说得很直白,它自己不造 QPU,思路是让各家 QPU 以加速器形式挂到 GPU 超算上,NVQLink 和 CUDA-Q 就是挂载接口。NVIDIA(NVDA)在这次合作里是平台方,接入的 QPU 越多,这套栈的标准地位越稳。
五、现场验证的分量与边界
这次安置给 IONQ 带来的,是云端上架给不了的一类背书:机器实打实放进 NVIDIA 的旗舰混合实验室,与 GB200 NVL72 经 NVQLink 直连,研究结果还要公开接受检验。现场验证加上共设计,让 IonQ 在量子-GPU 混合叙事里站到了靠前的位置。IonQ 董事长兼 CEO Niccolo de Masi 在通稿中把这次部署放进混合量子-经典时代的框架,提到多代 Superion 将与 NVIDIA AI 平台结合;路线图方面,他给出的方向是 10,000 qubits 与全容错,并借 SkyWater 的 CMOS 垂直整合加速推进。
这层背书的边界同样清楚。其一,2027 年的安装窗口属于前瞻口径,硬件交付、联调和验收都可能出现时间偏移。其二,通稿没有披露合同金额,外界无从判断这次安置对营收的贡献,也不宜自行估算。其三,研究中心安置不等于已确认收入或积压订单,NVAQC 这台机器的主要产出是公开研究和共设计指南,和商业客户按合同付费的交付性质不同。
把这些放回 IONQ 的投资逻辑里,这条消息加固的是生态位和技术叙事,短期财务能见度基本没有变化。后续更值得看的,是 IonQ 能否把“NVIDIA 现场首台”转化成其他超算中心和企业客户的采购理由。10,000 qubits 与全容错属于远期目标,和当前产品之间隔着多代迭代,如果预期里已经计入过多远期叙事,安装延期或结果平淡都可能被放大。
六、接下来的几个验证点
第一个验证点是 2027 年的安装确认。具体的装机季度、验收公告,以及首批经 NVQLink 和 CUDA-Q 跑通的混合作业,都是可核对的信号;如果届时公布 Superion 256 实际链路下的延迟和吞吐,就能拿来对照约 400 Gb/s、低于 4.0 μs 的平台规格。
第二个是开放结果与共设计指南能否落地。双方计划公开研究结果,可以观察论文、基准数据和代码的产出节奏,也要看金融组合优化、材料科学和计算化学三个方向里,有没有哪一项给出相对纯 GPU 方案的可量化改进。
第三个是 NVAQC 会不会迎来更多现场 QPU。早期合作方里既有同走离子阱路线的 Quantinuum,也有做中性原子的 QuEra;如果后续有其他厂商或其他模态的机器入驻,IonQ 的“首台”会变成“之一”,同一机房里的横向比较随之出现,这对 IonQ 是压力,对共设计研究反倒更有价值。
第四个是商业交付与研究机的区分。Superion 256 现已开放下单,首批客户交付同样预期在 2027 年,届时 IonQ 能否在财报和公告中把研究中心安置和付费客户交付分开披露,决定了外界能否看清这款产品的真实需求。2027 年会同时检验这两条线,NVAQC 这台负责证明技术能接进 GPU 超算,订单和收入则要到商业客户那一侧去找答案。