Anthropic 发布 Claude Sonnet 5.5:同价快三成、每任务成本最多省三成,Terminal-Bench 到 70.6%
Anthropic 在 2026 年 9 月 28 日发布 Claude Sonnet 5.5,这是 Claude 5.5 家族继上周 Opus 5.5 之后的第二款。价钱没动,还是每百万 token 输入 2 美元、输出 10 美元,但输出快了三成多,同一件活的成本最多能省三成。Terminal-Bench 4.0 从 Sonnet 5 的 10.3% 跳到 70.6%,GDPval-AA 只比 Opus 5.5 低两分,一个中档价位的型号,分数贴到了旗舰边上。
一、Claude 5.5 家族第二款到了
Opus 5.5 是 9 月 22 日发的,不到一周 Sonnet 5.5 就跟上了。发行人页开头把两者的关系讲得很直白:Opus 5.5 留给需要反复斟酌判断的复杂工作,Sonnet 5.5 是它更快、更便宜的互补款,去接边界清楚的日常任务。Sonnet 一直是 Anthropic 的中档主力,这一代的新鲜之处在于分数贴到了旗舰边上,Anthropic 自己也写了,几项测评里 Sonnet 5.5 开到最高力度档位,成绩和 Opus 5.5 相当。它同时补了一句边界,自家和外部测试都显示,遇到开放式、要持续拿主意的复杂工作,Opus 5.5 仍然明显更强,基准分只反映能力的一个切面。
二、修 bug、做文档幻灯片是它的主场
Anthropic 给 Sonnet 5.5 圈的强项是范围明确的日常任务和修 bug,再加上文档、幻灯片和表格这类要拿得出手的产出,顺带说它对设计有眼光,会给界面加打磨,也能照着幻灯片模板做出几乎不用改的成稿。发行人页举了个内部测试:把一家上市公司的季度财报材料和电话会记录连同幻灯片模板一起给它,让它做一份 10 页幻灯片的经营回顾,两位专家看过初稿后认为可以原样发出去。写作上它沿用了 Opus 5.5 那一代的改进,表达比上一代清楚,早期测试者的说法是比 Sonnet 5 更好合作;再加上速度快,不太复杂的任务上来回快速改几轮很顺手。有位测试者的用法很直白:让 Opus 5.5 定架构和大框架,具体实现放心交给 Sonnet 5.5。
三、同价 $2/$10,输出快了三成多
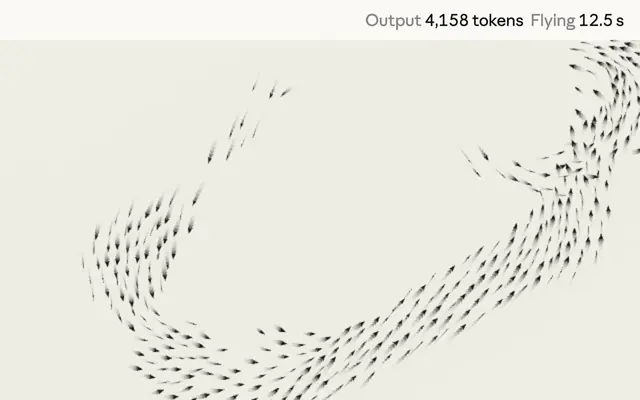
价格表和 Sonnet 5 一模一样:每百万 token 输入 2 美元,输出 10 美元,缓存读 0.20 美元。对照 Opus 5.5 的 4 美元和 20 美元,正好一半,缓存读两者都是 0.20 美元。速度上,Sonnet 5.5 生成输出比 Sonnet 5 快 30% 以上,Anthropic 说这是到目前为止最快的 Sonnet。发行人页放了三组同题对照录屏,例如让两个模型各用一个 HTML 文件写出 400 只椋鸟的群飞动画,快慢差距一眼能看出来。
快慢还能自己调。推理力度从 Low 到 Max 一共五档,Claude Code 和 Claude 应用里默认 Medium,Claude Platform 默认 High。档位越低回答越快、token 用得越少,适合例行工作;档位越高它想得越久,自查也更细。
四、同样的活,每任务成本最多省三成
单价没降,省钱的来源是 token 用量。Anthropic 说 Sonnet 5.5 做同一件事通常需要的 token 少得多,自家测试里每任务成本比 Sonnet 5 最多低 30%。早期测试者在对比运行里看到的是同一个机制:它更倾向于把多个工具调用打包一起发,步骤少了,账单跟着降。发行人页上几家客户给了自己的数。Balyasny 在 2,441 道金融任务的私有测试集上,Sonnet 5.5 平均每题用约 12.1 万 token,Sonnet 5 是 49.7 万;Slack 一个提示词没改,输出 token 少了约 14%;Lovable 的编码测评里工具调用少了三分之一,shell 执行次数大约减半;Base44 跑了 118 个真实应用构建,质量和 Opus 5 打平,平均 3.6 轮迭代交付,Opus 5 要 7.7 轮。放到 Anthropic 的成本曲线图上更直观:好几项测评里,Sonnet 5.5 开 Low 或 Medium 档就能超过 Sonnet 5 的最好成绩,每任务成本大约只要十分之一。
五、Terminal-Bench 从 10.3% 跳到 70.6%
编码这块的跳幅最大。Terminal-Bench 4.0 考的是在命令行里完成多步骤的专业任务,Sonnet 5 在这版题上只拿到 10.3%,Sonnet 5.5 是 70.6%。同一张表里 Opus 5.5 那格是 66.4%,Anthropic 在脚注里注明这是 Opus 开到 Xhigh 档的最高分,也就是说这一项上中档型号反超了旗舰。成本侧也交代了,Sonnet 5.5 在 Claude 应用默认的 Medium 档就远超 Sonnet 5 的最好成绩,每任务成本不到后者的十分之一。
CursorBench 4.0 取的是真实 Cursor 会话里那种指令含糊、跨多个文件的任务,Sonnet 5.5 拿到 55.5%,Sonnet 5 是 34.1%,Opus 5.5 是 57.8%,差两分出头。FrontierCode 1.1 主集上有个反常的地方:Sonnet 5.5 在 Xhigh 档是 52.1%,开到 Max 反而掉到 46.2%,Sonnet 5 是 42.4%,Opus 5.5 是 54.4%。Anthropic 自己解释了原因,Max 档更爱调用 Claude Code 的代码审查技能,把审查拆给一堆子代理去做,Cognition 复查的两个案例里一个超时,一个改到了题目范围之外,而这个基准专门给越界修改扣分,哪怕改得不错。同样开 High 档,它在 FrontierCode 上比 Sonnet 5 高 10 分,每任务成本约为后者的十五分之一。测试者的另一个观感是它读懂一个代码库很快,Epic Games 说它在游戏系统架构上处理了几万行代码,几个小时的长任务也撑得住。
六、GDPval 只差 Opus 5.5 两分
知识工作这边看 GDPval-AA v2.1,这套题从 44 个职业、9 个大行业里取真实工作任务,由 Artificial Analysis 跑分。Sonnet 5.5 是 1844,Opus 5.5 是 1846,Sonnet 5 是 1449,比上一代高了约 400 分,和旗舰之间只剩两分,同表的 GPT-6 Sol 是 1487。另一项考长程知识工作的 AA-Briefcase v1.1 上,Sonnet 5.5 是 1811,Opus 5.5 是 1822,Sonnet 5 是 1359;Anthropic 说在 Medium 档它就能压过 Sonnet 5 的最好成绩,每任务成本约为九分之一。这两项有个附注:Artificial Analysis 跑的是发布前的部署版本,当时 Claude Platform 上有个会拖累结构化输出的 bug,Anthropic 认为对分数的影响即便有也很小,而且是往低了算,bug 已经修了。电脑操作和看图这两块也跟了上来,OSWorld 2.1 从 57.0% 到 80.1%,图表识别 Chartography 从 15.6% 到 61.6%,都比 Opus 5.5 差不到三分;它还是第一个只看截图就通关《宝可梦 红》的 Sonnet。
七、API 和三大云当天上架
开发者侧当天就能用。Claude Platform 上模型 ID 是 `claude-sonnet-5-5`;Amazon Web Services、Google Cloud 和 Microsoft Azure 同日上架,Bedrock 上叫 `anthropic.claude-sonnet-5-5`,GCP 和 Azure Foundry 上沿用 `claude-sonnet-5-5`。和 Opus 5.5、Sonnet 5 一样,它支持零数据保留。分发侧 Vercel AI Gateway 也是 28 日当天挂出 `anthropic/claude-sonnet-5.5`,接了 Gateway 的编码代理可以直接选它。有一处迁移细节要留意:之前把思考功能关掉跑 Sonnet 的用户,迁到 5.5 之前得先切到新的 `between_tools` 设置,它的作用是继续关掉开头的前置思考,细节在迁移指南里。
八、对齐测试盯的是通用风险
Anthropic 自己的说法是,Sonnet 5.5 没有把模型能力的前沿再往前推,所以这次对齐评估只盯一组任何能力水平的模型都可能出的问题,比如做出违背用户利益的事、误导用户、配合高风险滥用。自动化行为审计覆盖约 1,850 个场景,Sonnet 5.5 在大多数对齐、抗滥用和诚实度指标上追平或好于 Sonnet 5;在新的封控测试里,它尝试逃出沙盒的频率接近表现最好的 Opus 5.5,主动试探容器边界的倾向是自家所有模型里最低的。护栏方面有个新变化:它的网络安全能力比 Sonnet 5 提升很大,所以成了第一个带 Opus 级网络安全护栏的 Sonnet,日常修 bug 不受影响,高风险的网络安全请求会明显地回退到 Sonnet 5 处理。生物方面的护栏和 Sonnet 5 相同。它也是第一个自带防推理提取分类器的 Sonnet,用来挡住靠海量假账号批量蒸馏能力的攻击,多数开发者不会察觉变化。
九、企业默认路由的迁移窗口
Claude Haiku 5.5 面向高吞吐、对成本敏感的场景,Anthropic 说未来几周加入家族。路透把这次发布放在 Anthropic 筹备 IPO 的背景下提了一句,并提到企业客户占其业务约八成,这块业务的动向,发行人页上的客户表态给了几个现成样本。CodeRabbit 说 Sonnet 5 动不动就去查网页、token 用得多的毛病在新模型上没了,简单和中等难度的代码审查现在就迁过去,更多的在接下来几周迁;Atlassian 说 Rovo 代理用它最多能比 Sonnet 5 快 30%;Zendesk 的测试里工单处理快了 20%。接下来几周要看的只有一件事:有多少团队把日常编码和文档流量的默认模型切到 Sonnet 5.5。