Google 发布 Gemini 4 Argon,先给 Fairwind 网防试用
Google DeepMind 9 月 30 日美东下午四点左右发布了新一代前沿模型 Gemini 4 Argon,但这次没有一上来就全面开放,眼下只通过 Fairwind 项目分批放给可信的网络防御方,开发者、企业和普通用户都还得等。同时公布的两个硬数字先记住:输出上限从 64K 拉到 100 万 token,介绍期 API 价格每百万 token 输入 2 美元、输出 10 美元。
一、今天宣布的 Gemini 4 Argon 先走 Fairwind
发布文章由 Google DeepMind 高级副总裁、Google 首席 AI 架构师 Koray Kavukcuoglu 署名,第一句话就把范围框住了:Argon 正在通过 Fairwind 项目向一批可信的网络防御方推送。Fairwind 是 Google DeepMind 9 月初刚设立的项目,用途就是把前沿能力分阶段交到防御方手里。
Google 自己的解释是,这个级别的前沿能力要安全放出去,只能一段一段走。文章说他们正在参与美国政府那套自愿性的模型预发布评估流程,一边逐步扩大访问范围,一边收集早期测试者的反馈,把护栏迭代好之后再尽快开放给开发者、企业和消费者。这里的措辞是「正在参与」,不是拿到了批准,也没有给任何时间表。
CNBC 当天下午四点的报道确认了分阶段这条线,Google 负责 Gemini 产品的 Tulsee Doshi 对他们的说法同样是先给防御方。所以今天到手的是一份公告加一组评测数字,模型本身还调用不到。
二、输出上限拉到 100 万 token
页面顶部 Google 自己的 AI 摘要写的是「100 万 token 上限」,很容易看成上下文窗口。正文写得很清楚,这次扩的是输出上限,从此前的 64K token 提到 100 万 token,涨了十五倍多。
Google 给的理由是长任务需要空间。模型有余量深想,在一条轨迹里一口气生成几十万 token,就能在一次运行里把一个硬问题啃到底,不用切成好几段来回接。它把自己定位在长时程工作流上也是这个原因,软件工程、法律金融这类知识工作、网络安全防御,都是一次要跑很长的活。
三、介绍价先是两美元和十美元
Argon 上线后会先按介绍价收费,每百万输入 token 2 美元,每百万输出 token 10 美元。介绍期结束后转成每百万输入 4 美元、输出 20 美元,正好翻一倍。命中缓存的输入 token 比输入价便宜 95%,也就是只收输入价的 5%。
页面上没有写介绍期什么时候结束,也没有给缓存输入的固定单价,这两个数别去猜。还有一层要说清,这套价格是给将来付费 API 用户看的,今天没有人能按这个价买到 Argon,API 还没开。
四、内部已经拿它优化量子和机房内存
Google 说 Argon 已经在内部工作流里跑着,几千名员工用下来,反馈最多的是专门领域的编码、更深的研究和写作质量。文章挑了几个内部例子。
一个在量子计算组。研究员用它优化那些卡住关键应用的子程序,目标是压缩量子比特数乘门数这项时空资源。有一个例子,它几分钟就比已发表的基线好了 40%。文章只给了这一例,没说这是普遍水平。
另一个在数据中心。一组 Argon 智能体分析全机群的性能剖析数据,自己找出并落地内存优化,推开之后释放了 300 多 TiB 内存,Google 估计全部做完能省 500 TiB 到 1 PiB。1 PiB 大约是 1024 TiB,所以这个 1 PiB 是估计上限,不是已经省下来的数。
五、C/C++ 改写 Rust 的活还在审计
第三个内部例子规模最大。Argon 智能体正在把 Google 内部的 C/C++ 代码库迁到 Rust,小的是 re2、libgav1 这类核心库,几万行;大的是 Fuchsia 的 Zircon 内核,超过 80 万行。这些系统太关键,改写出来的代码要过自动加人工审计、仿真测试和评审,之后才能进生产。眼下这些改写一个都还没上线。
libgav1 是 Google 开源的视频解码器,这个例子写得最细。Argon 智能体拿到一个已有的 Rust 移植版,把里面 3.2 万行 SIMD 代码换掉,方法是按性能剖析数据一轮轮做实验、盯着编译器的输出,写出让编译器自动向量化的安全 Rust。结果是一个内存安全的解码器,比原来的 Rust 移植版快 2.7 倍,视频输出完全一致,性能往优化过的 C++ 版本靠近了一步。
六、DeepSWE 77.9% 和一串企业评测
编码这块,Google 工程师日常已经在用 Argon 调试、做大规模迁移和算法设计。对外的数字是 DeepSWE v1.1 拿到 77.9%,这个评测衡量的是真实世界的长时程软件工程任务,Google 说是新的最高分。
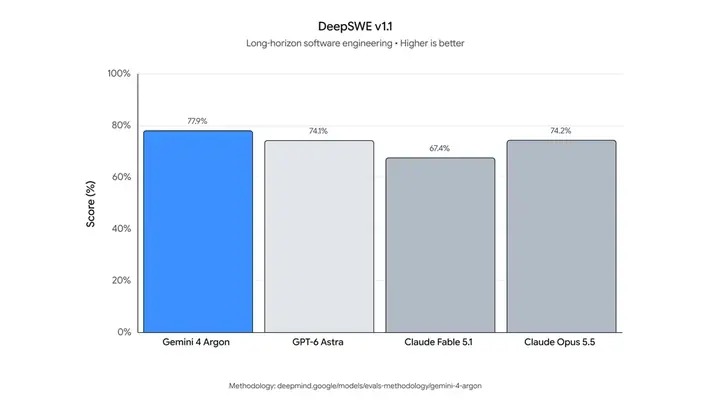
知识工作方面,文章说 Argon 在 Vals Index 上领先,这个指数覆盖金融、编码、法律和税务,每个领域按对美国 GDP 的贡献加权;在 Vals Finance Agent v2(多步金融研究)和 Harvey 的法律智能体评测(法律研究与起草)上也是领先,但这几项页面都没给分。给了分的是 Zapier 的 AutomationBench,考的是跨核心业务职能的端到端执行,Argon 以 51.3% 排第一。视觉理解上,长视频评测 LVBench 拿到 91.7%,同样是最高分。
Sundar Pichai 在 X 上发了一张对照表,把 Argon 和 GPT-6 Astra、Claude Fable 5.1、Claude Opus 5.5 摆在一起看。
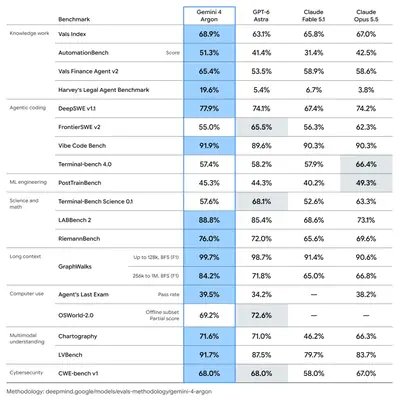
这张表不是清一色蓝。十九行里有五行是别家领先,FrontierSWE v2 上 GPT-6 Astra 65.5% 对 Argon 55.0%,Terminal-bench 4.0 上 Claude Opus 5.5 66.4% 对 57.4%,OSWorld-2.0 离线子集上 GPT-6 Astra 72.6% 对 69.2%。DeepSWE 那一行的第二名是 Claude Opus 5.5 的 74.2%,GPT-6 Astra 74.1% 紧跟着,Argon 领先不到 4 个点。图内数字以图为准,方法说明挂在 deepmind.google 的评测方法页。
七、网防能力先给可信防御方,护栏暂时不加
Google 说这次专门把 Argon 训练成擅长网络安全防御,能自己找到、验证并修补关键软件漏洞。对可信防御方和 Google 内部团队,这版会去掉网络安全方向的护栏,让他们用到完整的前沿级防御能力。这句话也是整个分阶段安排的根子,能力放到这个程度,收件人只能是筛过的。
Wiz 已经在用了,走的是它的 Scan for Good 计划,一个免费帮关键公共基础设施找高风险暴露并修复的项目。文章给了一个早期成果,模型在全球多家医院使用的医疗软件里发现了一个暴露敏感个人信息的严重漏洞,此前的前沿模型都没抓到。页面没有点名是哪款软件,也没有漏洞编号。
评测上,修补漏洞的能力看 CWE-bench v1,Argon 以 68% 并列第一。博客正文没说并列的是谁,Sundar 那张表里 CWE-bench v1 一格是 Argon 和 GPT-6 Astra 都 68.0%。这个 v1 是在 3.8 Flash Cyber 跑过的 v0 基础上做的新版本,两代分数不能直接比。找漏洞方面,Google 内部的综合漏洞评测覆盖 20 种编程语言的复杂代码库,Argon 挖出了范围很广的暴露点;Wiz 内部的黑盒渗透测试评测不给源码、只看在线系统,Argon 在摸攻击面、找漏洞、产出概念验证证据三个环节都好过 3.8 Flash Cyber。这两项都是相对旧模型的进步描述,没有具体分数。
八、广发前还在加四层护栏
Google 说在更大范围推开之前,还在四个方向加固前沿安全措施。
先是防滥用。针对网络攻击和化学、生物、放射、核(CBRN)这几类,模型按 Google 自家的前沿安全框架设计成拒绝有害请求,同时保留正当的双重用途科研。这次还在加强监测模型内部激活来识别滥用的技术。这些措施经过了内部和外部红队的鲁棒性测试,手工和自动攻击都用上了。
再是防提示注入。Argon 是 Google 目前对间接提示注入最有抵抗力的模型,这类攻击靠恶意指令或上下文来劫持模型行为。经过自动红队和对抗训练,它在 Gray Swan 的间接提示注入评测上领先,这项也只说领先、没给分。
第三项是监控失准。为了防止模型为了完成任务越过用户本意,Google 部署了监控 Argon 思维链和动作的机制,必要时直接停止执行。训练阶段也用了类似系统,异常会报给专门的事件响应团队。他们刻意不把这些监控发现直接喂回训练,怕的是把模型的推理塑造成会躲监控。文章顺带呼吁全行业在能力跃升的这个阶段保住推理透明度,让模型的思考过程还能用来诊断失准。
最后是加固系统。按 Google 的智能体控制路线图,高风险训练或评测开始前,沙箱环境要先隔离并封住。他们说会把这些智能体安全实践分享给合作方。
九、下一个看点是付费 API 和 Ultra 的开放窗口
文章末尾把顺序说清了,先靠这批网络防御方和可信测试者的真实反馈把系统加固,然后开放给开发者、企业和消费者,第一批是付费 API 客户和 Google AI Ultra 订户。没有日期。
对 Alphabet(GOOGL)来说,Argon 现阶段还不会体现在云和 API 的用量上,Fairwind 这批用户是测试场,收入还谈不上。真正要盯的就是付费 API 和 Ultra 订户什么时候能用上,介绍期的 2 美元和 10 美元也从那一刻才开始算。