Cloudflare 经 AI Gateway 上线 Web Search API:Ceramic / Exa / Linkup;按伙伴标价不加价
智能体要查实时网页,常见做法是先猜一个网址再去抓,猜错了就拿回一个 404。Cloudflare 10 月 2 日给的办法是 Web Search API:经 AI Gateway 调用,目前公开测试,首批接入 Ceramic.ai、Exa 和 Linkup,价格照三家标价走,一分不加。搜索差价它不赚,图的是把搜索请求也拉进自己的网关和账本,再给供货的爬虫立上规矩。
一、公开测试,首批三家搜索伙伴
这次上线的产品叫 Web Search API,目前处在公开测试阶段。Cloudflare 把它定位成跟搜索服务商的合作,开局的三家伙伴是 Ceramic.ai、Exa 和 Linkup,搜索结果由它们供应。AI Gateway 是这款产品的主入口。公告在 10 月 2 日美东时间上午 9 点 28 分发出。
二、模型的知识停在训练那天
模型训练完就定格了,只认得截止日期之前的世界。问它最近的新闻,或者某个刚改过的接口,它就很吃力。
Web Search API 补的就是这块。它在推理流程里加一层实时上下文,从网上取回新鲜的结构化片段,直接塞进模型的上下文。比起让智能体瞎猜网址,这更像人查资料的路数——先搜,再看。
三、一个 REST 接口,一行 Workers 调用
从现有后端或者外部服务发请求,走 REST 就行,用 POST 打到 `https://api.cloudflare.com/client/v4/accounts/{账户ID}/ai/websearch/`,带上认证令牌。请求体里放查询词和结果条数,指定用哪家伙伴,再写明走哪个网关。官方示例查的是「秋天快到了,盐湖城有什么好玩的」。
在 Workers 上开发更省事,一行 `env.AI.websearch()` 就够,参数跟 REST 基本一致,返回的结果解析成 JSON 就能交给智能体。
限制写得很清楚。单次查询最长 1024 个字符,结果条数只能在 1 到 10 条之间;不指定伙伴的话,默认走 Ceramic.ai。想先上手,可以拿 AI Gateway 的账号和密钥去 AI Playground 里试,Cloudflare 也说以后还会有别的接入形式。
四、搜索费用从网关额度里扣
Cloudflare 给 AI Gateway 的定位是应用的控制面,可观测和统一计费是内置的,安全和访问控制也在里面。联网搜索这回直接挂了进来。
落到使用上,搜索查询从 AI Gateway 的额度余额里扣,请求跟模型调用一样出现在平常的网关日志里。谁能用哪家搜索伙伴,也能在网关这层管起来。
自带密钥(BYOK)照样支持,跟接模型供应商一个做法。已经跟某家搜索伙伴开了账号的团队,能把现成的配置带过来,几步就接上。
五、每千次 0.25 美元到 7 美元
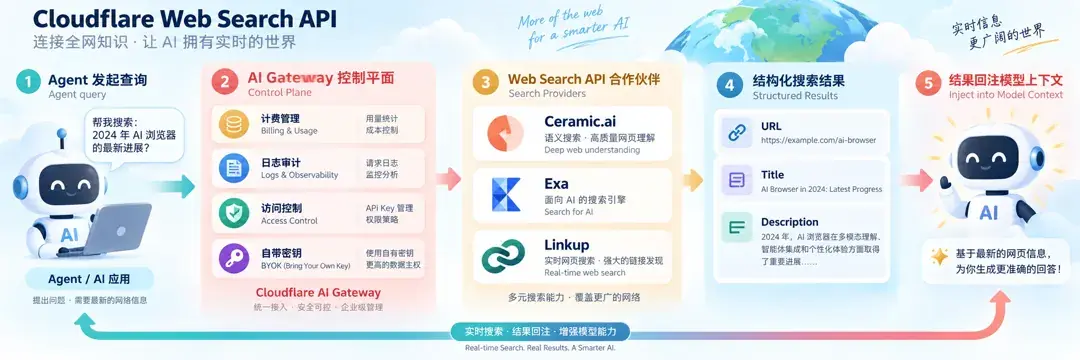
价格照伙伴的公开标价收,Cloudflare 不加价。按开发者文档里的价目表,Ceramic.ai 每千次查询 0.25 美元,Linkup 5 美元,Exa 7 美元。Ceramic 用的是自建索引,收录超过 400 亿个网页。
三家价差拉得很开。同样跑 100 万次查询,走 Ceramic 花 250 美元,换成 Linkup 要 5000 美元,Exa 要 7000 美元,Exa 的单价是 Ceramic 的 28 倍。默认伙伴 Ceramic 恰好也是最便宜的一家。
数据留不留也会标出来。Cloudflare 说会标明哪些伙伴支持零数据留存。眼下这还是一个将要标出的栏目,不是一份已经公布的名单。
搜索这一层的差价,Cloudflare 等于主动让了出来,它要的更可能是黏性:开发者为了搜索往网关里充额度,日志和权限也放在这儿,模型调用跟着留下的可能就更大。放到 NET 身上,这项业务的分量要看它能把多少 AI 开发者的调用量带进 AI Gateway,搜索费本身不是看点。
六、伙伴的爬虫要守 Cloudflare 的规矩
三家伙伴都答应按 Cloudflare 的爬取标准来,条件有两条。一是搜索服务商用的爬虫,要符合 Cloudflare 开发者文档里对「已验证机器人」的公开要求,说白了就是亮明身份、遵守 robots.txt;二是每条搜索结果都得附上被抓内容的来源链接。
Cloudflare 的说法是,爬虫应该老实透明,尊重网站定下的机器人规则和偏好,站长也该真正看得见、管得了自己的内容怎么被用。它把这次合作称作给「好爬虫」立标准的又一步。
这套规矩由 Cloudflare 来定很顺。它本来就站在大量网站前面管机器人流量,现在自己卖搜索,先让供货的爬虫守它的规矩,站长那头也好交代。
七、服务端工具还没正式上线
Cloudflare 同时预告了下一步,正在把服务端工具(Server Tools)原生做进 AI Gateway。做成以后,开发者不用再自己定义工具,工具直接内置在控制面里,联网搜索会是首批之一。它只说「很快」,没给日期,眼下还没正式上线。
在那之前,想让模型自己决定什么时候搜,得手动编排。官方示例的做法是,先在模型调用里声明一个搜索用的函数工具;模型想搜,会返回一个工具调用,拿里面的查询词去调 `env.AI.websearch()`;再把搜索结果当作工具消息塞回去,让模型重新作答。
下一个要盯的节点就是服务端工具正式上线。到那一步,搜索成了网关里现成的一项,开发者省掉这一套来回,AI Gateway 能不能借此多拉住一批 AI 开发者、多收一份钱,就看得出来了。