Mistral Large 4 公开预览上线,万亿参数开放权重的放出日指向 10 月 27 日
美东时间 10 月 6 日,Mistral 在自家 Studio 平台打开了 Large 4 的公开预览,文档上写的是 26.10 版。它是细粒度混合专家,总参数 1.05 万亿,每次激活大约 490 亿,视觉编码器另有 16 亿参数,图片和文字都能进,输出只有文字。博文把放权重写成月底前,路透社、华尔街日报和 VentureBeat 写成 10 月 27 日,中间大约三周先做红队,许可证和最终检查点都还没定。
一、文档页标着 26.10 版公开预览
内部叫它 Le Chonk,网上说的就是那种特别胖的猫。今年 6 月 X 和 Reddit 上流传过一个虚构的 Mistral「胖猫」大模型段子,Lample 对 VentureBeat 说,可以把 Large 4 看成这个梗的第一个真版本。页面上的状态是公开预览,并标了开放。Mistral Studio 里现在就能调接口。
上下文给到 100 万 token。结构化输出和函数调用都能用,批处理开着,智能体接口也在这版里。
二、一次推理大约只动二十分之一参数
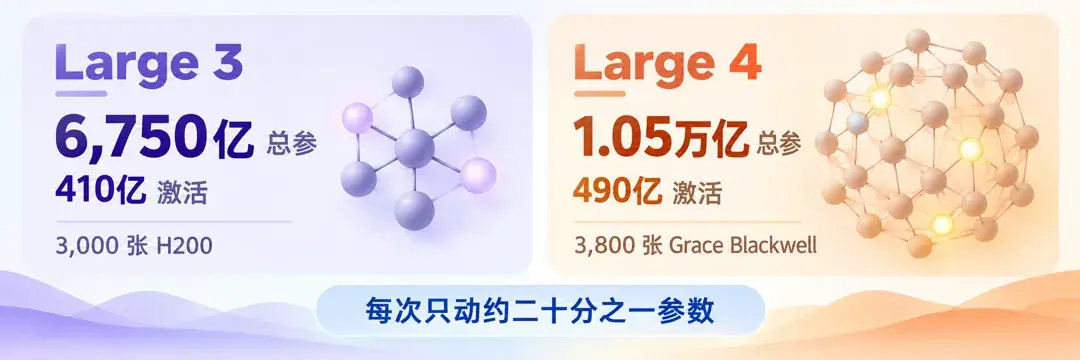
490 亿激活对上 1.05 万亿总参数,大约是二十分之一。官方博文写,训练在自家欧洲机房完成,用 3,800 张英伟达 Grace Blackwell 从头训。CNBC、华尔街日报和 VentureBeat 写成大约 4,000 张,时间大约两个月。上一代 Large 3 是 6,750 亿总参数、410 亿激活,训练用了 3,000 张 H200。
强化学习还没跑完。Mistral 博文说这块现在大约是 3,000 张卡的规模,一次训练一天产出大约 330 亿 token,其中大约 160 亿能拿来训练。公司说还没看到饱和。
价钱要分两处看。博文标价是每百万 token 输入 1.36 美元、输出 4.18 美元。文档页眼下打五折,输入 0.68 美元,缓存 0.07 美元,输出 2.09 美元。折到哪一天,官方没写。五折价看着像预览期优惠,不能当成正式标价。
三、放权重的日期写成 10 月 27 日
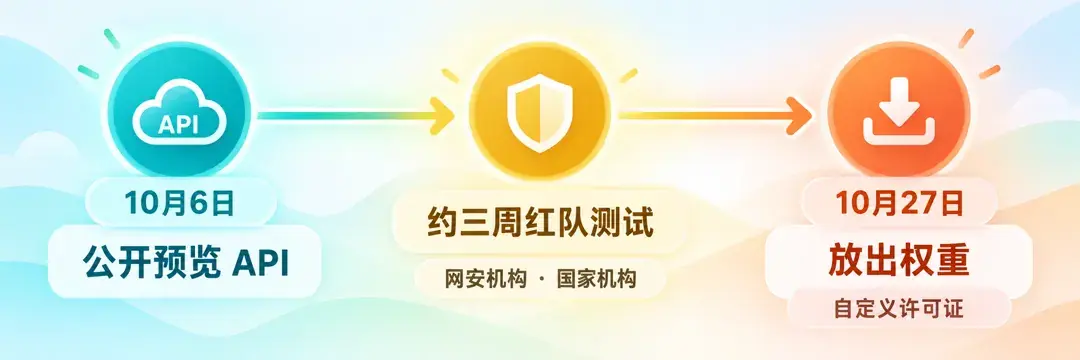
预览窗口大约三周。公司拉上网安机构做真实场景测试,审核过的伙伴和国家机构也在这批人里。他们拿到的是同一个模型,审核更松,网络能力更强。路透社的说法是安全护栏更少的版本。
博文的时间表是本月底前放出权重。路透社、华尔街日报和 VentureBeat 都写成 10 月 27 日。许可证按 VentureBeat 的核对,会换成 Mistral 自己的自定义条款,Large 3 用过的 Apache 2.0 不再沿用。商用限制的细则还没公布。最后放出的检查点,分数也可能和预览版不一样。
四、真实开源软件漏洞复现修补拿到 82%
网络安全是博文最想讲的能力。公司称,Artificial Analysis 的网络安全指数里,Large 4 排全球前五,在中国以外的开放权重模型中领先。把真实开源软件里的漏洞复现出来、再打上补丁,这项得分 82%,博文称全场最高。Claude Opus 5.5 和 GPT-6 Astra 在这项上接近零分,因为它们拒答。Cybench 一共 40 道竞赛题,解出了 93%。
恶意网安请求上,它的拒答率高于其他开源模型。Lakera 的 B3 抗攻击成绩是 93.3%。防守方要的是能把漏洞真实跑通的模型。闭源厂商一拒答,正常的复现和修补就停住。权重开放之后,可以按自己的规则放在私有云,也可以放在本地。路透社写到的背景是,OpenAI 和 Anthropic 已经在限制网络能力最强那些系统的访问。联合创始人兼首席科学家 Guillaume Lample 说,这套防御能力能帮企业和政府,防的是把闭源模型越狱之后拿去发动攻击的人。
五、自报的 DeepSWE 是 61.7%
编码这边先看公司预览期自报。DeepSWE v1.1 是 61.7%,SWE-Atlas-QnA 是 59.4%。终端环境的 Terminal-Bench 4 报了 28.3%。编码智能体综合 49.8%,公司说这项领先 DeepSeek V4 Pro 0813,也领先 Qwen3.8 Max。Surge 做了代码质量盲评,五个模型里 Large 4 得 3.74,排第二,Claude Opus 5 是 4.22。业务流程上还自报了 AutomationBench 59.9%,覆盖 657 个业务流程。
VentureBeat 拿公开榜对过。DeepSWE 实时榜按各家最佳配置来排,GLM-5.3 和 Kimi K3 大约 69%。闭源前沿大约 74%,里面有 GPT-6 Astra 和 Gemini 3.8 Flash,Claude Opus 5 也在这一档。61.7% 大约就是 62% 这个量级,有竞争力,但不是这张榜的第一,也不是开放权重第一。预览公布的时候,Large 4 还没进 Artificial Analysis 的公开评测,DeepSWE 榜上也还没有它。CNBC 同样写了,编码仍然落后前沿。
法律项看 Harvey 的法律代理测试,Mistral 自己的图上,Large 4 预览版是 15%。Vals.ai 公开榜里,Kimi K3 是 12.92%,GLM-5.3 是 8.33%,和图里的竞品数对得上。Finch 自报 67%。视觉定位 Dense 200 自报 42%,对照的 GPT-6 Astra 是 41%。后面这两项的竞品数,VentureBeat 没找到公开出处。
「中国以外最强开放权重」,还有「跟全球最强的开源有竞争力」,以及领先幅度很大,都是公司说法。首席执行官 Arthur Mensch 在阿布扎比说,某些方面高于中国模型,网络安全包括在内。他没点是哪些模型,也没点是哪项指标。上面这些中国模型的数字只作对照。
六、三星 9 月领投了 30 亿欧元
训练和预览都在 Mistral 自己的欧洲机房。公司有一套欧洲部署,整条链路自己运营,归欧洲法律管,不依赖其他数字服务商。训练数据覆盖 160 多种语言,欧盟的官方语言都在里面。客户用来定制的 Mistral Forge,和训练、定制是同一套环境。
Lample 接受 VentureBeat 采访时把生意说得很直。权重会越来越像大路货。钱在部署和算力,也在定制和工程服务。客户已经超过 125 家。名单里有空客,ASML 和汇丰也在。
今年 8 月起,Mistral 向客户转售第三方模型。路透社写,第一个是 Z.ai 的 GLM 5.3。自家旗舰补到 Large 4 之后,靠转售去顶旗舰空档的那层尴尬会轻一些。
9 月这轮 D 轮由三星领投,融了 30 亿欧元,投后估值逾 210 亿欧元。Large 4 是这笔钱的第一个里程碑。欧洲自有算力还在扩。Lample 的科研团队从 3 人扩到大约 300 人。
七、10 月 27 日要看许可证和最终检查点
落到上市公司身上,这件事只有间接的弱映射,因为 Mistral 没有上市。英伟达是训练卡的供应方,也是 Mistral 的老股东,9 月 D 轮同样跟投;Mistral 说 D 轮的钱正在扩自家欧洲算力,多出来的训练卡需求会落在英伟达这条供应线上,但一家公司的几千张卡撑不起英伟达的业绩判断。ASML 在 2025 年 9 月领投 C 轮,出资 13 亿欧元,当时公告的是约 11% 的完全稀释股份,首席财务官进了 Mistral 战略委员会;D 轮继续跟投,现在的持股比例没有披露,Large 4 能不能落地,对 ASML 来说更多是一笔股权投资的估值问题。
产业这头,科学副总裁 Pierre Stock 对路透社说,希望和 ASML、三星把整条价值链的合作做深,模型能做芯片设计;会不会和三星一起把芯片造出来,他没有评论。三星 9 月公布的合作,是把 Mistral 的模型做成本地部署版本,用到自家芯片工厂的缺陷检测和设备优化上。
接下来只盯 10 月 27 日:自定义许可证把商用限制写成什么样,最终检查点能不能在 Artificial Analysis 和 DeepSWE 这类第三方榜上复现预览期的分数。