OpenAI公开未发布模型写出的722篇数学手稿:372个结果族,Lean形式化目录只列162篇、仍标未审核
10月6日美东时间傍晚6点,OpenAI把一个还没对外发布的内部模型写出的722篇数学手稿放上GitHub,整理成372个结果族。目录里点名的有π的无理性指数恰为2、自由群因子同构、卡普兰斯基直接有限性猜想的反例,全是OpenAI自己的说法。能让电脑逐行检查的Lean形式化目录只列了162篇手稿、185条主结果声明,还标着部分进展、未审核。模型没公开,逐题提示词没给,也没经过同行评审,数学界一边想看答案,一边要OpenAI拿出能复现的记录。
一、这份目录按结果族组织
这次发布由两部分组成:OpenAI的研究帖《分享人工智能在数学上的进展》,以及同日公开的GitHub数学仓库。《科学美国人》报道,仓库在美东时间傍晚6点对外公开。
722篇是手稿数,372个族是归并后的结果数。按仓库说明,一个族围着一条主结果,可以带上配套论证、推论,也可以收进另一种证明。所以一份手稿未必对应一个独立问题,同族几份手稿也只算一个结果。
总览把这些族分进17个数学学科,编号只跟目录顺序走,跟重要程度无关。手稿日期大多落在9月23日到10月5日,10月6日是集中公开的日子。
二、模型评测已经扩到开放研究题
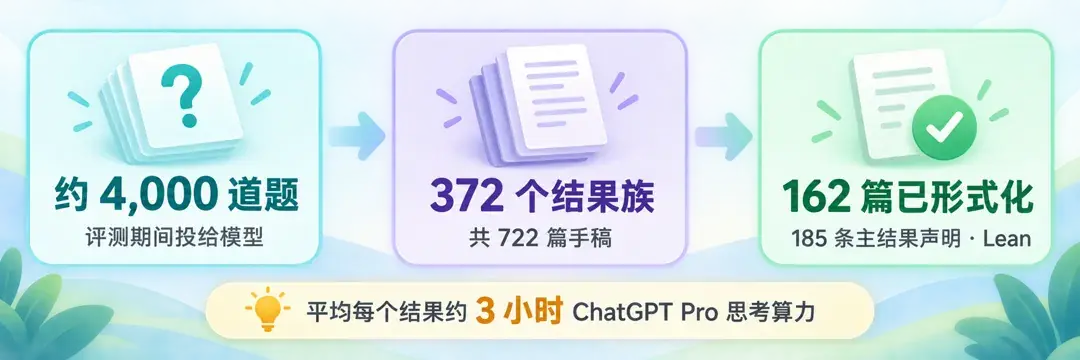
仓库说明交代了来龙去脉:OpenAI原有的数学评测已经刷到饱和,于是把评测扩到开放研究题。整个评测期间,模型一共被投了约4,000道题,有些产出还用到了模型更早得出的结果。
按仓库说明的自述,「绝大多数」结果出自同一个未发布的内部模型,走的是同一套固定流程。平均每个结果用掉的思考算力,大约相当于3小时ChatGPT Pro。这里的ChatGPT Pro只是折算算力的尺子,算的是内部模型的用量,公开版用户手里并没有这个模型。
产出先归并成结果族和手稿,再过一道「重要程度够格」的门槛,才收进目录。研究帖另外说,仓库里附了尝试题数的统计和按ChatGPT Pro折算的算力估计。
三、固定流程之外还有两项例外
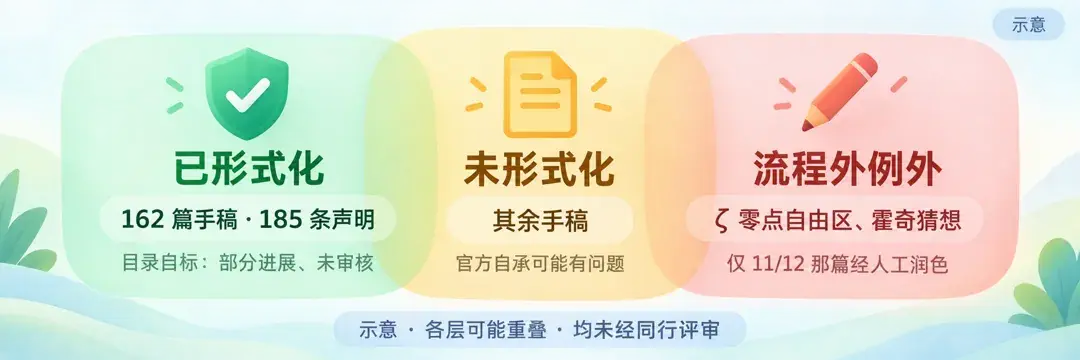
仓库说明点了两项不走固定流程的工作:黎曼ζ函数零点自由区的相关工作,以及带复乘的阿贝尔簇上的霍奇猜想证明。说明没写零点那项具体指哪几篇。它另外交代,实部大于11/12的零点自由区那篇,文字经过人工编辑,为的是更好读。
这一项要对着总览看。003族的主结果是所有狄利克雷L函数(包括ζ函数)在实部大于7/8的半平面上没有零点,目录把它写成「解决了准黎曼猜想」。实部大于11/12出自同族一篇伴随稿,用另一种方法证明了这块范围更小的零点自由区域。明确经过人工润色的只有11/12这篇。
7/8那篇主稿同时出现在Lean形式化目录里。也就是说,「已形式化」和「流程外例外」这两类在003族里是叠在一起的,按类别切开数会重复。
四、Lean目录标着部分进展、未审核
Lean是一种能让电脑逐步检查数学证明的语言。仓库里的形式化目录列出162篇手稿,对应185条主结果声明。185条是声明数,一篇手稿可以挂好几条。
目录对自己的状态写得很直白:范围一栏是「部分进展」,审核一栏是「未审核」,方法一栏写着由智能体自动完成。目录里另有30条,记的是mathlib4这类上游数学库,关系标为「在其上构建」,是证明要调用的现成材料,不另算成果。
登记进目录和拿到独立复核记录还是两回事。电脑查的是写进系统的命题、定义和证明;数学家还得确认,被检查的命题跟手稿里的说法是不是一一对应,限定条件有没有悄悄变了。
《科学美国人》的判断是,通过Lean验证的结果几乎可以肯定是对的,但这批证明里有没有新想法,还是旧技巧重新拼装,数学界可能要花几个月才看得清。没配形式化的那部分,仓库说明自己承认「可能有问题」,并说会尽快修正。整批材料都还没经过同行评审。
五、π和群代数的主张写在OpenAI目录里
以下几条都按OpenAI自己的目录摘要转述。目录称证明了π的无理性指数恰为2,并顺带得出Flint–Hills级数收敛。自由群因子那条写的是L(F₂)≅L(F₃),进而所有插值自由群因子同构。群代数那条说,造出了一个有限表示的无挠群,它在二元域上的群代数不满足直接有限性,由此否定卡普兰斯基猜想。三维挂谷极大猜想和四维挂谷维数问题也列在总览里。
仓库还放出10份节选版推理摘要,π、马勒猜想、自由群因子、卡普兰斯基这几条都在其中。外界能多看到一点模型走向结果的过程,但节选摘要不是完整的逐题生成记录。
六、发布方式离顾问组的建议还差逐题披露
研究帖说,OpenAI一直在征询设在普林斯顿高等研究院的独立顾问组「数学与人工智能顾问组」,参考了它的建议和公开建议来安排这次发布。据《科学美国人》报道,这个顾问组是OpenAI在9月21日宣布组建的,起因是纳维-斯托克斯那次发布引出的争议。
这次的落脚点是GitHub。修订记成新版本,旧版本继续保留;每篇手稿目录里都有引用条目。研究帖也说,还在找符合顾问组准则的社区托管方式,以后的发布会在引用、数学表述和呈现上继续改进。
差距在逐题披露。《科学美国人》报道,顾问组的建议要求每个结果都公开所用模型、准确提示词和计算时长;OpenAI这次只给了平均算力和一些统计,提示词一条没有。发言人对该刊说,公司认真对待这些建议、尽力照做,但不受其约束。
研究帖还承诺,会资助一系列研讨会、会议和专项计划,帮人理解人工智能做出的重大结果,细节「近期」公布。产出这些手稿的模型,研究帖说正在「负责任地」推进发布;OpenAI对《科学美国人》的说法是尽快且负责任地放出来。时间表都没给。
七、单个智能体的说法出自发言人
「一个智能体、一条提示词」这个说法,来源是OpenAI发言人对《科学美国人》的表态:几乎所有结果都是这样做出来的。同一位发言人也承认,有些结果可能试了不止一次。
《科学美国人》在报道里自己做了对照:9月8日纳维-斯托克斯那次结果,是靠约1万个智能体组成的集群做出来的,算力花了数百万美元。按发言人的说法,这次的产出方式要轻得多。不过「平均约3小时」只是算力折算,推不出总花费,也替代不了外部复现。
八、数学家对公开节奏看法不同
麻省理工学院的数学家安德鲁·萨瑟兰盯着复现。他对《科学美国人》说,在模型公开、别人能复现结果之前,单个智能体一次做成这类说法都应当视为未经证实,「我们应该要收据」。
多伦多大学的丹尼尔·利特更看重公开本身。他说,既然想知道这些数学题的答案,就没理由让公司把答案藏起来,这对数学是好事。
据《科学美国人》报道,陶哲轩此前公开批评过OpenAI等前沿实验室产出人工智能数学结果的节奏「太疯狂」。同一篇报道里,OpenAI发言人承认,不少新结果连公司自己的数学家都还没吃透,但公司不打算放慢。
上一轮的余波也还在。《自然》9月17日报道,OpenAI在9月8日宣布用人工智能解决纳维-斯托克斯问题之后,争议延伸到了功劳归属:同样在用人工智能工具攻这道题的人类数学家,他们的想法有没有被模型学了去。
九、独立复核还要追上手稿体量
放到资本市场上看,这批手稿离业绩很远。OpenAI没有上市;微软(MSFT)是它的主要股东和云伙伴,英伟达(NVDA)跟它的联系在训练和推理算力上。如果「平均约3小时算力出一个结果」站得住,前沿数学这类长推理任务就是在按小时消耗算力,这跟微软的云和英伟达的推理芯片挂得上钩。但这是间接、偏弱的映射,单凭一次数学材料发布推不出收入变化,也谈不上股价结论。
更实在的观察点只有一个:Lean目录的覆盖面能不能追上722篇手稿。现在它记的是162篇、185条,还标着部分进展、未审核。下一次更新时,覆盖数涨了多少、审核状态有没有从未审核改过来,比目录里再多几个结果名字更能说明问题。