EmbeddingGemma 2:7.4亿参数把文字、代码、图片、音频和视频编进同一向量空间,手机本地就能搜
10月6日美东时间中午12点,Google DeepMind 发布开放嵌入模型 EmbeddingGemma 2,权重放上 Hugging Face 和 Kaggle,用 Apache 2.0 许可,可以商用。它有7.4亿参数,把文字、代码、图片、音频和视频编进同一个768维向量空间;按 Google 博客,量化后在 Pixel 11 Pro 上全模态只占约567MB活跃内存,手机本地就能做跨媒体搜索。
一、这是一款独立的端侧嵌入模型
前代 EmbeddingGemma 去年发布,只处理文本,下载逾2,000万次。EmbeddingGemma 2 基于 Gemma 4 架构,Google 说它和 Gemini 嵌入模型出自同一套技术,这次把范围扩到代码、图片、音频和视频。它是单独的嵌入模型,不是 Gemma 4 的新版本。
二、同一个向量空间让跨媒体搜索成立
嵌入模型不负责写字。它把一段文字、一段代码或一份媒体压成一串数字,也就是向量;训练之后,意思相近的内容在空间里挨得近,不相干的离得远。搜索时,系统把查询变成向量,再到资料库里找离它最近的几条。
搜索、检索增强生成、分类、聚类和去重,底层都是这一步。用一句话找视频里的某一段,用一段语音备忘录找相关录音,都在同一个空间里完成;一条输入也可以把文字、图片和视频混在一起,最后只得到一个向量,能直接和其他内容比较。
放在手机上跑,好处很具体:资料不用上传,延迟更低,没网也能查。再配一个 Gemma 4 这样的生成模型,EmbeddingGemma 2 先找资料,生成模型再根据找到的内容回答,就是手机上的本地检索增强生成。
三、编码器按需加载,内存随任务变化
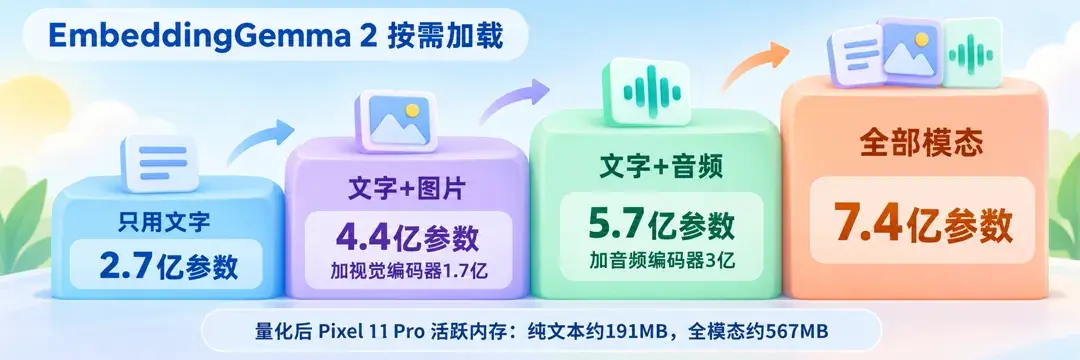
模型卡把7.4亿参数拆成三块:文本主干2.7亿,视觉编码器1.7亿,音频编码器3亿。文本主干内部又分成1.3亿参数的变换器层和1.4亿参数的嵌入层,视觉和音频两块都可以不装。
所以只做文字时加载2.7亿就够;文字加图片是4.4亿,文字加音频是5.7亿,视觉和音频都开才是7.4亿。博客给的手机数据是,量化后在 Pixel 11 Pro 上,纯文本活跃内存约191MB,全多模态约567MB。这个设计的要点不是把大模型硬塞进手机,而是任务用不上的编码器干脆不加载。
它还和 Gemma 4 共用文本分词器和音频编码器。手机上一个模型负责回答、一个负责找资料时,共用的部件能压低两者合计的内存;两边仍是各自独立的模型。
四、前面的维度先装最重要的信息
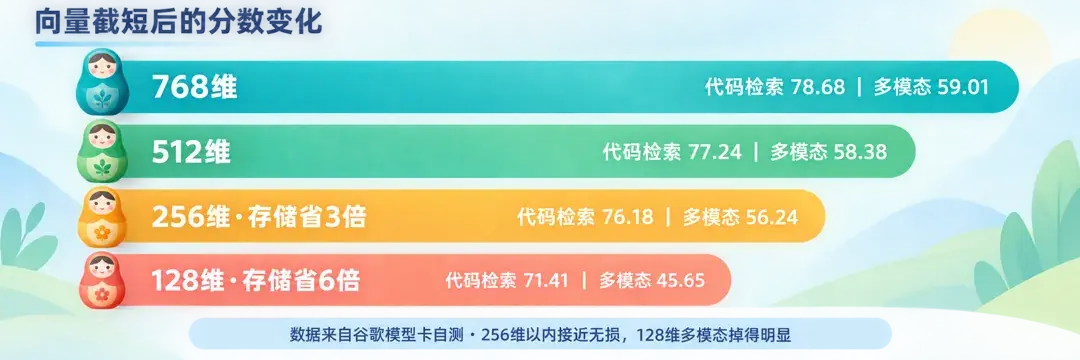
EmbeddingGemma 2 用套娃式表示学习训练,排在前面的维度先承载最重要的信息,后面的维度补细节。因此默认768维的向量,可以直接只留前512、256或128维。截到128维,存储降到原来的六分之一,Google 把这写成向量库存储和内存最多省6倍。
按单精度浮点存储做简单折算,一条768维向量约3KB,截到128维约0.5KB。对手机上的本地索引来说,这个差距直接决定能放多少资料、比对一次要算多少。
代价写在模型卡的截维表里。代码检索在768维、256维、128维时分别是78.68、76.18和71.41;多模态基准 MMEB 的总分是59.01、56.24和45.65;音频检索基准 MSEB 是69.54、66.76和56.71;文本多语言是61.36、60.41和57.89。模型卡自己的结论是,截到256维以内接近无损,128维时多模态掉得明显,更适合纯文本,上线前要拿自己的数据再验一遍。
五、所有媒体共用一笔上下文预算
上下文窗口是8,192个词元,是前代的4倍。词元就是输入被切开后的小段,这笔预算由文字、图片、视频和音频一起分,不是每种媒体各领一份。
单独处理时,每张图片默认占280个词元,大约能放29张;视频每帧默认占140个词元,大约能放58帧,模型卡写明默认每秒取一帧,按这个帧率简单折算,约等于一分钟的视频;音频每秒占25个词元,最多约327秒,博客写成约5.5分钟。
混排时各模态争的是同一笔预算,加了文字,能放的图片、帧数和音频时长都会变少。把视觉预算调低,图片或视频帧最多能塞到约114个,换来的是每张画面的细节变少,这是拿表示精度换容量。
六、代码检索比前代高出近10分
文本多语言和前代基本持平:大规模文本嵌入基准 MTEB 的多语言项是61.36,前代61.15;模型卡还写明支持100多种语言。变化最大的是代码,MTEB 代码项从前代的68.76升到78.68,高出9.92分,模型卡把代码任务的提升写成约14%。Google 因此专门点了本地代码库索引、语义代码搜索和编程智能体找代码这几类用途。
多模态这边,模型卡列出的成绩有图片基准 MIEB 精简版64.64、MMEB 的视频项50.67、音频基准 MAEB 49.39,前代没有这些能力,也就没有可比的分数。
Google 在博客里称它「同尺寸最佳」,原话的范围是10亿参数以下的多模态嵌入模型,举的基准是 MTEB 代码和 MAEB;博客还说它能追平或超过不少更大的模型,并超过一些两倍多大小的专用模型。模型卡的说法更收着,写的是「10亿参数以下最强的多模态嵌入模型之一」。
这几句都得带着限定读:分数是 Google 自测,模型卡的对照表只列了自家前代 EmbeddingGemma,没有任何竞品分数,第三方榜单的复测也还没出来。
七、几个部署细节会直接改变结果
文本输入的任务前缀不是装饰。搜索、问答、事实核查、代码检索、分类、聚类和相似度比较各有对应写法,不加也能出向量,但准度会下降;图片、音频和视频不用加前缀。
截维之后一定要重新归一化,把向量拉回单位长度,否则排序会悄悄变差,程序不会报错。查询和文档也必须用同一个维度,不能拿768维的查询去比128维的文档库。
数值精度上,模型卡要求别用标准半精度 float16:模型的激活值超出它能表示的范围,结果会变成空值,或者看着正常、其实已经变差。推荐用 bfloat16,或者单精度 float32。
还有两条边界。预训练数据截止到2025年1月。它没有做生成模型那种后训练安全对齐,安全措施主要放在预训练数据过滤上,应用层的检索过滤、公平性测试等防护由开发者自己负责。
八、下载入口和端侧工具首发就接上了
权重现在可以从 Hugging Face 和 Kaggle 下载;Google 云上 Gemini Enterprise Agent Platform 的 Model Garden 只写着即将上线,没有日期。手机和跨平台应用可以走 Google AI Edge 的 MediaPipe 或 LiteRT,浏览器里有 transformers.js 和 WebGPU 两条路。
开发工具这边,Google 列了首发合作的一串名字:transformers、sentence-transformers、MLX、vLLM、llama.cpp、SGLang、Ollama 和 LMStudio 负责跑模型,Qdrant 负责存向量,Unsloth 给了微调指南。从把本地内容变成向量,到保存检索,再到按业务微调,每一段都有现成的工具。
Google 自己的演示也说明了落点。Google AI Edge Gallery 里有即时媒体搜索和视频片段定位;Foresight 应用把 EmbeddingGemma 2 用来检索本地文件,再交给 Gemma 4 做推理。它要做的不是手机上的聊天,而是先把手机里的资料理清楚。
九、同尺寸最佳还要等第三方复测
放到美股里看,这和 Alphabet(GOOGL)只是弱的间接关联:开放模型生态,加上安卓和 Pixel 的端侧入口,有长期的战略意义,但这次发布带不来能单独量化的营收。高通(QCOM)和苹果(AAPL)只是端侧芯片和本地智能这条叙事的背景,从一个开放模型的发布推不出对它们的投资结论。
接下来真正要看的,是第三方在 MTEB 和 MAEB 上的复测,能不能脱开 Google 自测的口径,坐实「同尺寸最佳」这句话。