微软计划从2027年起把Azure Maia扩到多吉瓦,Maia 300拟进入生产部署
微软计划从2027年起把自研的Maia芯片扩到多吉瓦部署,目标也说得很清楚:服务自家产品和服务的主要推理需求。一个Maia 300机架装96颗加速器,功率包络167千瓦,带27.6 TB HBM;微软拿来比较的单位也很直接,是每兆瓦、每瓦能产出多少token。
一、微软把自研芯片推到多吉瓦
10月12日,微软云与AI执行副总裁Scott Guthrie宣布,公司将从2027年起把Azure Maia家族扩展到多吉瓦部署,让Maia成为微软产品与服务的主要推理系统。他把这一步放在“超级智能时代”的基础设施新阶段里讲。
这里的范围是微软自己的产品和服务,包括Copilot、Teams、GitHub Copilot、Microsoft Foundry等。它说的是推理,不是训练,也没有推出一个面向所有客户按小时租用的Maia云实例。
二、Maia 200已经接住生产负载
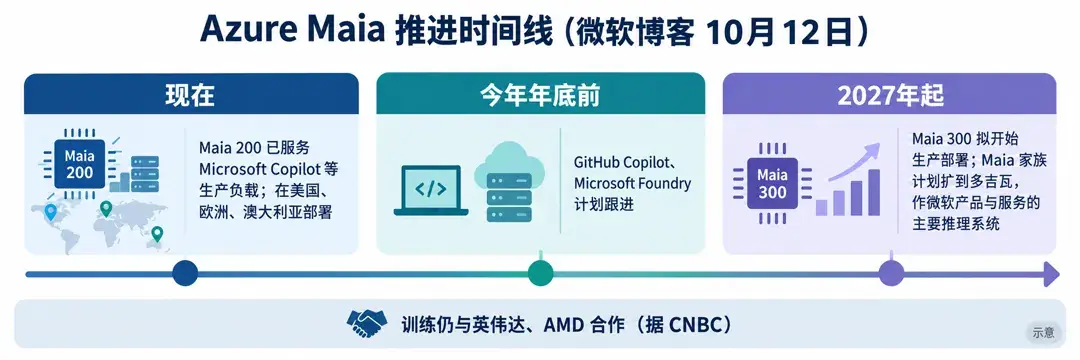
Maia 200已经在服务微软生产负载,包括Microsoft Copilot,也在支持MAI团队开发下一代模型。GitHub Copilot和Microsoft Foundry计划在年底前跟进。当前已经跑在Maia 200上的负载,涵盖OpenAI模型、微软自研MAI模型,以及主流开源模型家族。
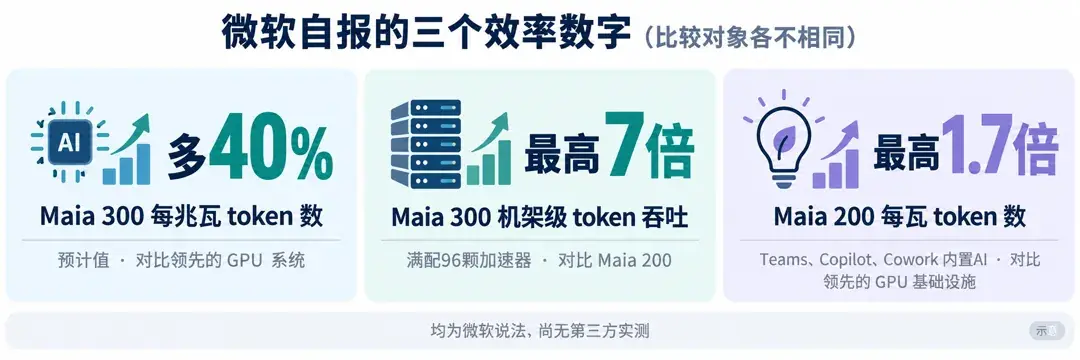
这套芯片正在美国、欧洲和澳大利亚部署。微软自报,在Microsoft Teams、Copilot和Cowork体验里的内置AI能力上,Maia 200每瓦产生的token数量,最高达到领先GPU基础设施的1.7倍。这个数字只对应这些具体体验和效率口径,不代表所有工作负载都能得到同样结果。
三、Maia 300把设计重心放在推理
Maia 300是Maia计划的第三代,也是一套完整的智能系统。它优先服务长上下文推理、对延迟敏感的对话,以及持续运行的多步智能体任务。微软列出的应用方向包括GitHub的多步智能体编码、Microsoft Foundry的云规模模型服务、MAI团队的推理和数据生成,还有面向低延迟交互的Dragon Copilot,帮助减轻临床医生的行政负担。
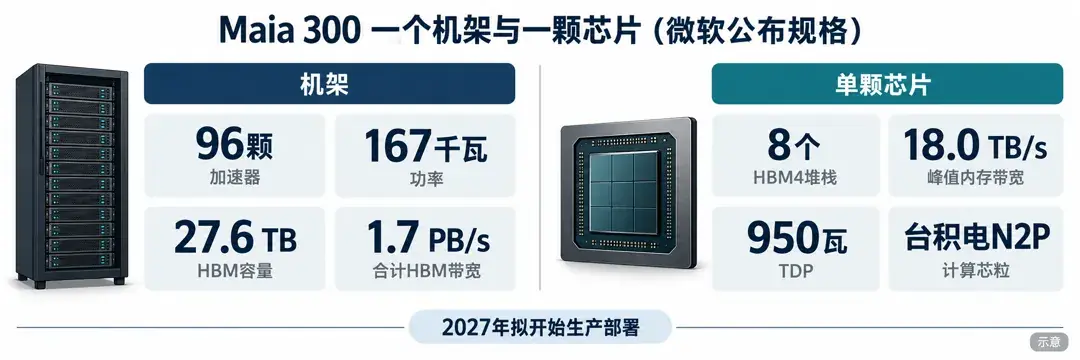
芯片本身有8个HBM4堆栈,每颗配288 GB HBM,峰值内存带宽18.0 TB/s,芯片TDP为950瓦。片上SRAM被设计成软件管理的暂存区,用来减轻HBM压力。新的多芯粒架构把计算、内存控制器和I/O拆开,计算芯粒采用台积电N2P工艺。
Maia 300还使用增强版MXFP4低精度格式,减少计算和KV缓存对内存及带宽的需求。软件定义的数据流架构、AI辅助的内核优化,都围绕少搬数据展开;芯片之间则通过基于以太网的自定义AI传输做纵向扩展互联。规格图列出的峰值指标为FP4 13.8 POPS、FP8 6.9 POPS。
四、一个机架装下96颗加速器
Maia 300的满配机架包括96颗加速器、24个四卡托盘,功率包络167千瓦,HBM容量27.6 TB,合计HBM带宽达到1.7 PB/s。微软称,机架里的加速器密度是Maia 200的两倍。按单颗芯片算,Maia 300的内存带宽是Maia 200的2.5倍,容量多33%,每瓦HBM带宽约为两倍。
散热也按这种密度重新设计。液冷可以带走机架80%以上的热负载,既能接入设施冷却水,也能通过换热单元放进风冷机房。两层网络最多可以把128个机架连成一个超级节点,总计12288颗加速器。
五、三个效率数字各有比较对象
微软预计,Maia 300相比领先的基于GPU的系统,每兆瓦能多出40%的token。这是对外部领先GPU系统的预期比较,不是第三方实测。
另一个数字是满配机架的结果:Maia 300的机架级token吞吐最高达到Maia 200的7倍。技术白皮书还称,机架每瓦性能最高达到Maia 200的2.5倍。至于前面提到的1.7倍,它属于Maia 200在Teams、Copilot和Cowork内置AI能力上的每瓦token效率,比较对象是领先GPU基础设施。
这些数字放在一起,指向的是同一个推理瓶颈。芯片算得快,不等于系统吐得快。长上下文和解码负载会让数据搬运、内存容量和带宽越来越重要,所以微软把重点放在固定电力里能产出多少token,而不只报峰值算力。
六、主要推理系统没有覆盖训练采购
Maia成为微软自家产品和服务的主要推理系统,并不等于微软停止采购GPU,也不等于Maia会替代训练集群。CNBC转述微软总经理Alistair Speirs称,微软训练模型仍与英伟达和AMD合作。
Maia目前也和谷歌TPU、亚马逊Trainium走着不同路径,外部公司不能按小时租用它。分析师Patrick Moorhead表示,微软之外还没有人测试过这些芯片。换句话说,Maia首先是微软内部产品体系的专用底座,规模和效率要先在自家服务里兑现。
七、多吉瓦部署还没有时间表
按微软计划,Maia 300拟于2027年开始生产部署。多吉瓦部署的具体时间表还没有公布,Speirs表示要保留选择余地,因为行业变化很快,需要在合适的时间为合适的模型使用合适的芯片。
下个月的Microsoft Ignite 2026将在11月17日至20日于旧金山和线上举行,Guthrie说届时会分享更多战略和技术进展,没说会谈Maia的部署节奏。值得观察的是,大会会不会给出多吉瓦部署的推进节奏,或补充Maia 300的更多数据。对MSFT来说,这关系到自家产品推理基础设施的控制力;对NVDA和AMD来说,微软自有产品的推理采购份额可能被分走,但训练合作仍在继续。Maia 300的计算芯粒采用台积电N2P工艺,TSM可能受益则取决于这套计划最终的量产规模。