Meta 发布 Muse Wonder,预览版接入 Meta Model API,Muse Wonder Full 只给 Muse Code 高阶订阅
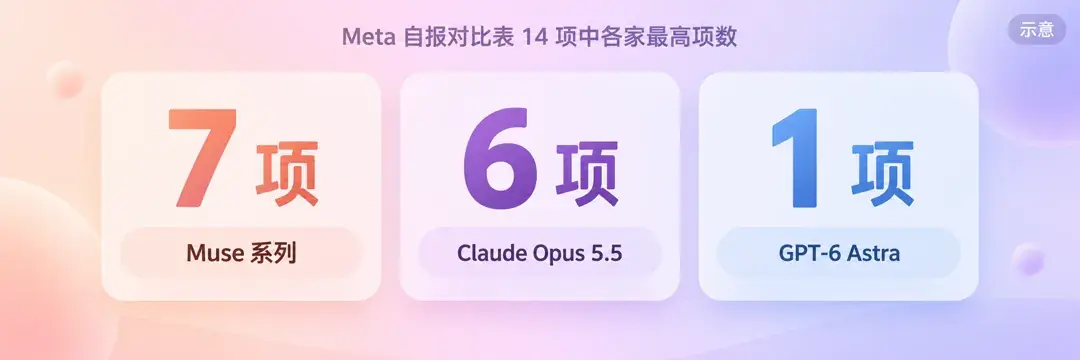
Meta 自己的对比表里,Muse 系列在 14 项拿下 7 项最高,但 Artificial Analysis 智能指数上,Claude Opus 5.5 仍以 58 对 Muse 最高的 56 领先。10 月 12 日开发者能调用的是 Muse Wonder,更强的 Muse Wonder Full 仍只在 Muse Code 订阅里。
一、Muse Wonder 系列包含两款模型
Meta AI 研究博客和新闻室在 10 月 12 日发布 Muse Wonder 与 Muse Wonder Full。Meta 称它们是迄今最强、面向个人和职业智能体任务的模型,并把发布称为“扩展阶梯”的下一步、迈向“个人超级智能”的一大步;“业界领先”也是 Meta 的自称。
Meta 说,团队 14 个月前从零重做 AI 工作,模型建立在 4 月推出的 Muse Spark 之上,预训练和强化学习都有推进。两款模型在 Meta 吉瓦级 Prometheus 数据中心训练,采用更大、更强的基座模型;Meta 据此称,它们在未专门训练的陌生任务上,好于按 Muse Spark 1.3 趋势预期的表现。
博客和新闻室把两项能力命名为 Active Memory 与 Active Focus。按 Meta 的说法,前者跨对话记住重要信息,并在需要时主动调出;后者在任务变难时换办法、绕过障碍、从错误恢复,需要澄清就请求,重要操作前先确认。Meta 举的场景包括保险理赔、租约、财务或健康信息,以及从游戏到新业务应用的编程。
二、API 先开放 Wonder,Full 留在订阅里
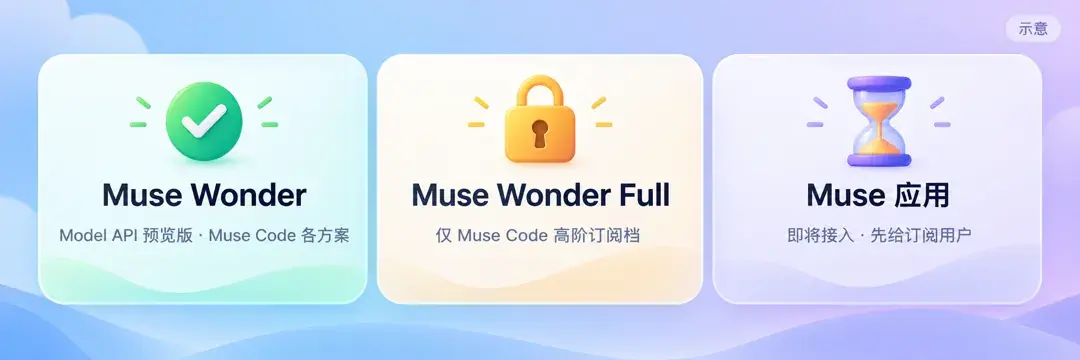
开发者文档显示,10 月 12 日 Muse Wonder 通过 Meta Model API 和 Muse Code 提供,型号为 muse-wonder-1.0,API 标为预览版。能力更高的 Muse Wonder Full 只在 Muse Code 的 Power Usage、Maximum Usage 两个订阅档提供;它不上 API,Wonder 调到 max 也不会变成 Full。
Meta 说,Muse Wonder 即将接入 Muse 应用,先给订阅用户。模型页还列出开放权重的 Muse Glimmer,源自 Muse Spark 蒸馏,可下载自部署;Wonder 走托管 API 和订阅,没有开放权重,参数量未披露。
三、Wonder 的标准 API 价格更高
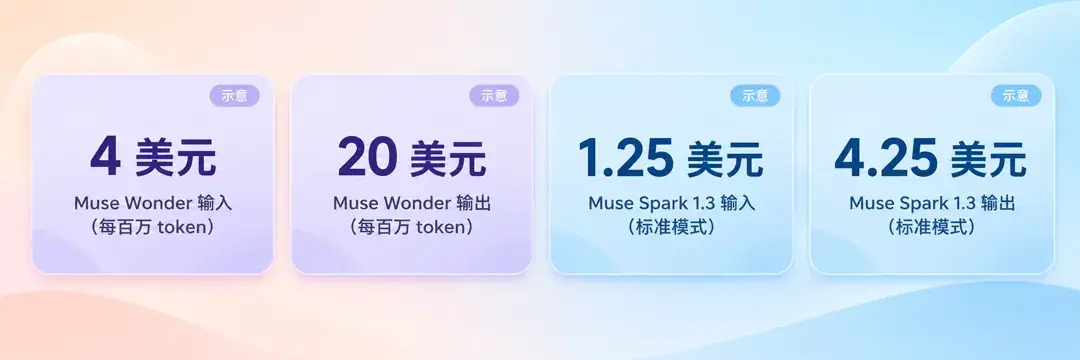
开发者定价页显示,标准模式每百万 token 输入 4 美元、缓存输入 0.20 美元、输出 20 美元;Muse Wonder 在 Model API 上没有贡献者模式,也就是允许 Meta 用用户内容训练未来模型以换取折扣。
同页的 Muse Spark 1.3 标准模式为输入 1.25 美元、输出 4.25 美元,贡献者模式为 0.10 美元、0.20 美元。照此计算,Wonder 输入约为 Spark 1.3 标准模式的 3.2 倍,输出约为 4.7 倍。
Wonder 上下文窗口为 1048576 个 token(约 100 万),支持文本、图像、视频、音频和 PDF 输入,输出文本,推理强度从 minimal 到 max。文档建议,长时间复杂任务用 Wonder;量大、低延迟或控成本用 Spark。
四、Meta 的对比表让 Muse 系列拿下 7 项最高
Meta 博客表格让 Muse 使用最高推理档,对比 GPT-6 Astra、Claude Fable 5.1、Claude Opus 5.5 的 max 档。按 Meta 公布的 14 项表,Muse 系列 7 项最高:PSI 59.1、Harvey LAB-AA 13.1、Vals Finance Agent V2 59.1、AutomationBench-AA 45.4、DeepSWE 1.1 79.0、SWE-Marathon 57.5(Full 用 xhigh 推理档)、Meta 内部 MemoryBench 85.6(Muse Wonder)。
Opus 5.5 有 6 项最高:Artificial Analysis 智能指数 58,对 Muse 最高的 56;Terminal-Bench 4.0 59.6,对 57.1;ProgramBench 70.5,对 59.0;以及 HealthBench Pro、JobBench、OSWorld V2.1 的部分得分。OSWorld 严格完成率最高是 Claude Fable 5.1 的 43.1,Opus 那栏只有 Anthropic 自报的部分分数、没有严格完成率;GPT-6 Astra 在 GDP.pdf 最高。
Artificial Analysis 官网与 X 帖给出的智能指数为 Muse Wonder Full 56、Muse Wonder 52、Muse Spark 1.3(max)48。
五、不同测试口径进入同一张表
模型卡称 PSI、MemoryBench、FocusBench 是 Meta 内部基准。DeepSWE 1.1 的 Muse 两款与 Opus 结果来自 Datacurve,GPT-6 Astra 用 OpenAI 自报,Fable 5.1 用 Anthropic 系统卡;SWE-Marathon 全取 Abundant AI 榜单,GPT-6 Astra 和 Fable 5.1 分别跑 Codex、Claude Code,并非同一测试框架。
Harvey LAB-AA、AutomationBench-AA、Terminal-Bench 4.0 和 AA 智能指数来自 Artificial Analysis,Vals Finance Agent V2 来自 Vals AI,GDP.pdf 来自 Surge。Meta 也承认,内部竞品成绩只是“尽力而为”,提示词、工具和环境未必为对手优化;拒答按零分计且留在分母里。模型卡也写明,外部编码成绩沿用各报告方自己的测试框架或智能体产品,SWE-Marathon 这一行不是受控的同框架对照。
六、安全评估把化学与生物列为重点
模型卡按 Meta 的“超级智能扩展框架”评估,以 Full 结果代表全系列。未加缓解时,Meta 不能排除模型在化学与生物领域达到其框架的高风险阈值,因此加入针对性安全后训练和系统级分类器;网络安全、失控在缓解前已是“中等或更低”,加上防护后各领域均为“中等或更低”,Meta 据此部署。
博客称 Wonder 是 Meta 迄今对齐最好的模型,这也是 Meta 的自称;更完整的安全报告即将发布,10 月 12 日尚未公开。
七、开发者实际采用仍待验证
据英国《金融时报》专访,扎克伯格称 Meta 已追上对手、站到 AI 前沿,会继续大笔投入与 Anthropic、OpenAI 竞争,并拒绝放缓开发。对直接相关的 META,唯一值得继续看的,是 Wonder 预览版能否转成持续的开发者采用:每百万 token 输入 4 美元、输出 20 美元的价格是否能在真实任务里留下来。英伟达等算力供应商与 Meta 投入的关系,以及谷歌、微软、亚马逊的竞争影响,都只能作为随投入变化的推论。