NVIDIA 联合发布 OCP 机房与电网规范,拟与 Cisco 推 USFP 光模块
AI 机房的尺寸被四家写进一份公共规范:机柜高 100 英寸,最重单柜设计目标 8000 磅,机柜排峰值按每英尺 350 千瓦计算。另一份规范把问题推到并网点,要求电压回到 0.90–1.10 标幺值后,算力负载在 2 秒内回到故障前 90%;背景之一,是 2024 年 8 月北美一次 1500 兆瓦负荷同时脱网。
一、开放基础设施发布从机房延伸到网络
10 月 12 日,NVIDIA 官方博客汇总圣何塞 OCP(开放计算项目)全球峰会的开放基础设施发布:设施侧有 Open Data Center 0.7 和电网扰动接口规范 1.0.0,机架侧有通过 MGX 1.2 贡献给 OCP 的 Vera Rubin 设计,网络侧则是与 Cisco 计划推出的 USFP、Meta 宣布采用 Spectrum-6,以及 Google Falcon 将支持 NVIDIA 未来的 ConnectX-10 和 BlueField。0.7、1.0.0 是规范版本,MGX 1.2 与 Vera CPU 机架是设计规范,USFP 仍是计划,不对应已建成机房或已出货模块。
二、四家合著的 v0.7 统一了机房物理尺寸
《Open Data Center: Next-Generation ML Infrastructure Design Principles》修订版 0.7.0 署名 AMD、Google、Meta、Nvidia,生效日为 2026 年 8 月 27 日,面向 2027–2028 年及以后系统。它从 Google 于 2025 年 12 月 2 日首发的 0.3.0、2026 年 2 月 25 日更新的 0.5.0,走到 6 月 23 日修订的四家版本;Google 专属的近期表格、TPU 集群扩展和园区布局被删去,范围转向全行业 AI 和机器学习系统。
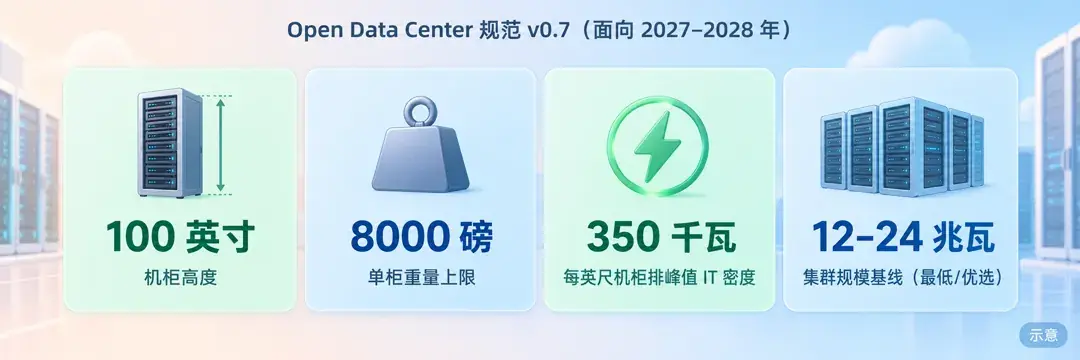
机柜统一 100 英寸(2540 毫米)高、71 英寸深,最重单柜目标 8000 磅(3629 公斤),占地 28 英寸宽×48 英寸深;算上交直流侧柜,峰值合计 15000 磅。规范把 12 英尺运输通道列为设计要求,双母线槽配置下层高至少 18 英尺,推荐通道间距 24 英尺。规范的用意是让托管商、第三方供应商和云厂商按公共条件开发制造;NVIDIA 称,设备商和运营商可以开始设计、制造、交付,不必等各家客户的私有规格。
三、排长改按每英尺功率密度来定
v0.7 删除固定排长要求,改按每英尺机柜排的功率密度模块化设计。混合平均为 25 千瓦/英尺,需要 15 千瓦/英尺风冷能力加 25 千瓦/英尺液冷能力;峰值 IT 密度为 350 千瓦/英尺,规范又写 2027 年机柜峰值 IT 预计 125 千瓦/英尺,高密度区液冷上限预计 335 千瓦/英尺加 15 千瓦/英尺风冷。这些都是每英尺机柜排的数,不是每柜功率。
集群基线是最低 12 兆瓦、优选 24 兆瓦,每个数据大厅至少 4 个供电单元。规范举例的高效设备包括冷却用 Project Deschutes、供电用 Mt. Diablo,后者通过高功率机柜采用更高电压直流电提升配电效率。按规范的说法,改用千瓦/英尺,是为了更好适应不断变化的供电和液冷连接需求。
四、电网规范要求算力负载 2 秒内回到 90%
电网文件全名为《Interface Specification Between Hyperscalers and Utility Grid for Disturbance Performance》,版本 1.0.0,生效日 2026 年 9 月 17 日,贡献方是 Google、Meta、Microsoft、NVIDIA。规范记录,2024 年 8 月北美有 1500 兆瓦负荷同时脱网,今年 7 月 22 日美国东部互联电网又发生规模更大的类似事件;大负荷突然脱网会推高频率和电压。
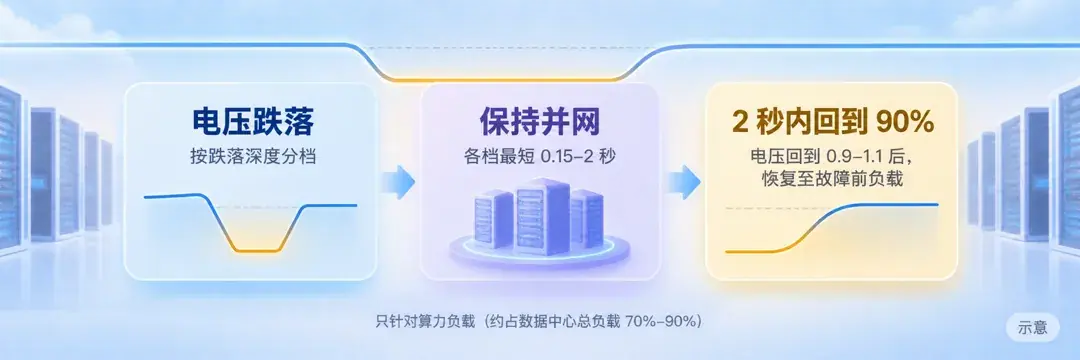
它只针对算力负载,并在并网点测电压。0.80–0.90 标幺值要撑 2 秒,0.50–0.80 撑 0.5 秒,这两档都可按电压比例降功率;0.35–0.50 撑 0.25 秒,低于 0.35 撑 0.15 秒,后两档功率可降到任意值。1.10–1.20 要撑 1 秒并保持恒功率,超过 1.20 可立即转备用电源。只要回到 0.90–1.10,算力负载必须在 2 秒内恢复到故障前 90%。NVIDIA 博客说的是不到两秒恢复到接近满载,规范表格写的则是 2 秒内回到 90%。
五、实施建议给既有设施留出边界
规范称算力负载通常占数据中心总负载 70%–90%。冷却设备多用变频驱动,跳闸后恢复可能要几分钟,规范认为单靠固件升级达不到穿越要求,当前也无法承诺时间表;辅助负载通常不到 1%。可能的办法包括修改机柜级整流器或电源固件,利用电容储能撑住,但各家电源设计不同;另一条路是中压 UPS,但规范说多数情况下给老机房加装成本太高、改造太折腾。
四家采纳的是 MISO 2026 年 7 月提出的惯例,与得州 ERCOT 的 NOGRR 282 提案非常接近。实施上,四家提议设生效日:此前已投运或已签并网协议的设施终身不强制;老站点超出原协议的扩容只管新增部分;生效日后才进入负荷研究和签约的设施,投运时就要达标。频率穿越、频率变化率、相位跳变、功率爬坡率和强迫振荡,留到后续版本。
六、MGX 1.2 把 Vera Rubin 设计交给 OCP
NVIDIA 通过开放 MGX 把 Vera Rubin 机架和计算托盘关键设计贡献给 OCP,并与行业伙伴通过 Open DC 计划提供第三代 MGX AI 数据中心参考设计。MGX 1.2 加入机架级盲插液冷、可互操作机架互连、面向高功率系统的液冷 5000 安培母排、原生 19 英寸设备支持、更高密度机架、可配置 I/O 槽位、无风扇液冷计算托盘和标准化供电冷却接口,支持最高 250 千瓦机架部署。NVIDIA 称,装配、测试和维修时间会因此改善。
Vera Rubin NVL72 的设计面向大规模训练和推理,Vera CPU 机架设计面向工具调用、编排和沙盒执行,帮助 AI 智能体实时与应用、数据和服务交互。DSX OS 新增四个开源组件:批量配置交换机的 Config Manager、训练前模拟真实负载的 Cluster Readiness Engine、做固件管理的 Rack Management Service,以及面向 NVIDIA Infrastructure Controller 的 Cluster API Provider;NVIDIA 称后者可把裸机变成可用集群的时间从几天缩到几小时。Visionbay 另公布围绕 800 伏直流架构的 K-1 计划,结合 NVIDIA 参考架构和 Vertiv 供电散热技术。
七、USFP 仍是计划中的光模块规格
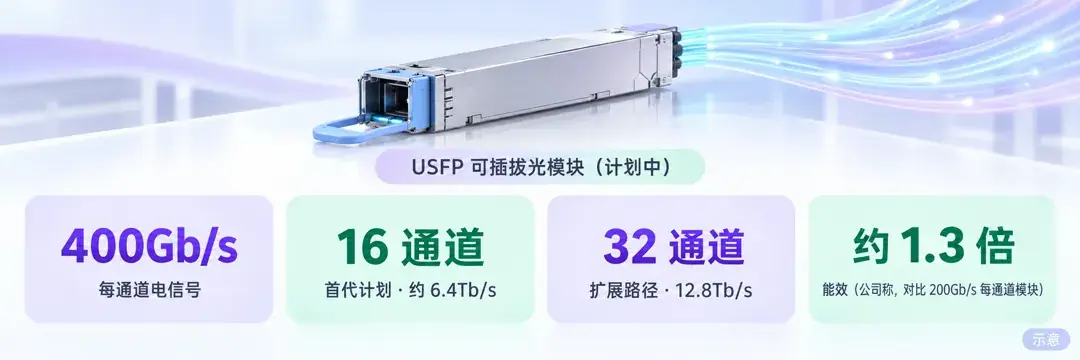
10 月 12 日,NVIDIA 和 Cisco 宣布计划推出 USFP,即超高密度小型可插拔规格,目标为 400Gb/s 每通道。首批计划中的模块在 OSFP 大小外形里放 16 条全双工通道,同时支持交换机和 SuperNIC 网卡;Cisco 博客写明,16 条乘 400Gb/s 是 6.4Tb/s,未来扩到 32 条以上,才有通向 12.8Tb/s 的路径。
两家称,USFP 被设计为首个支持 400Gb/s 每通道电信号的模块;相比 OSFP 大小的 200Gb/s 每通道模块,其带宽和前面板带宽密度约 4 倍,能效约 1.3 倍。新闻稿给出的模块最高功耗是 100 瓦,不需要另加专用冷却回路。它采用二维阵列连接器和两步插入设计,先插到位,再接通高速触点。TE Connectivity、Amphenol 正参与笼子、连接器和模块开发,社区主导的多源协议项目也计划启动;据 SDxCentral 报道,Cisco 高管 Rakesh Chopra 说更多细节会在未来几个月公布。
八、Spectrum-6 和 Falcon 把互连继续往上推
Meta 宣布采用 NVIDIA Spectrum-6 102.4Tb/s 以太网交换机。NVIDIA 称,它的交换容量和每通道带宽都是 Spectrum-4 的两倍,每通道 200Gb/s;Meta 的 N-IceCube 交换机装进液冷网络机架 IcePack,运行开源网络操作系统 FBOSS。NVIDIA 博客称,Spectrum-X 多平面技术可把 GPU 流量分到最多 8 个独立网络平面,支持超过 10 万块 GPU 的 AI 工厂。
Google 这边,NVIDIA 和 Google 宣布,NVIDIA 未来的 ConnectX-10 SuperNIC 和 BlueField DPU 将支持 Falcon 传输协议,应用仍可使用标准 RDMA 编程接口。
九、USFP 多源协议文本成为下一观察点
往下看,最具体的一步是 USFP 多源协议项目何时公布规范文本、哪些厂商加入。现在点名的笼子、连接器和模块合作方是 TE Connectivity(TEL)与 Amphenol(APH),直接宣布者是 NVIDIA(NVDA)和 Cisco(CSCO)。如果未来几个月出现文本和更多参与者,市场可能更容易判断 16 通道、400Gb/s 每通道的规格能否走向开放生态;在此之前,约 4 倍带宽和前面板密度、约 1.3 倍能效仍是两家公司口径。