d-Matrix 发布风冷集群 Squadron,开始向优先客户出货
一家做推理芯片的私营公司,把产品从一张卡、一个机架推到最多16个机架、1024颗芯片的集群,而且全风冷,按公司说法能直接放进客户正在运行的机房。峰会现场另一项演示把注意力留给GPU,把专家层搬到Corsair:一台8卡服务器配一到两块H100,公司的测量显示,单块H100每个输出token耗时从2.59毫秒降到1.28毫秒。
一、Squadron把推理规模推到16个机架
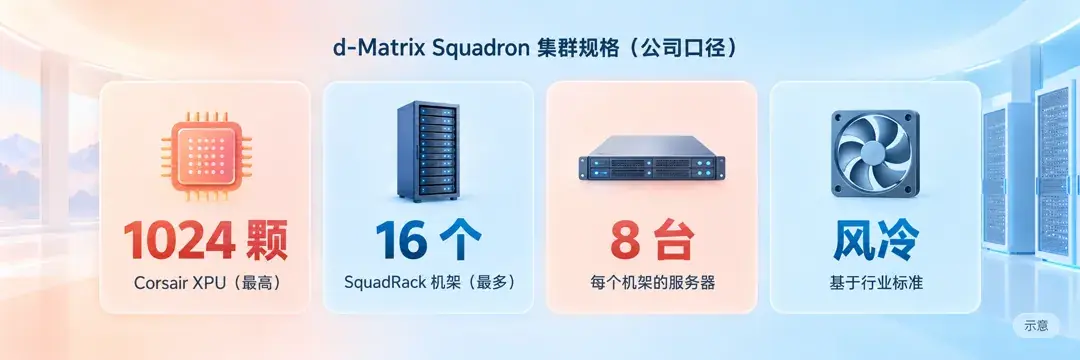
10月12日,在圣何塞OCP全球峰会开幕日,创始人兼CEO Sid Sheth在会展中心主题演讲公布Squadron。新闻稿把它定义为提供兆瓦级高能效推理算力的多机架系统:最多16个SquadRack,每个机架装8台服务器,最高1024颗Corsair XPU。产品页的满配机架是8台服务器、64张卡,16架正好对应1024颗。
集群用JetStream网卡互联,由Aviator软件部署,面向AI实验室、企业和主权机构。公司列出的场景包括写代码、个人智能体、网络安全和高频交易,新闻稿把这些都归为对延迟敏感的应用。
二、可用状态已经分成三层
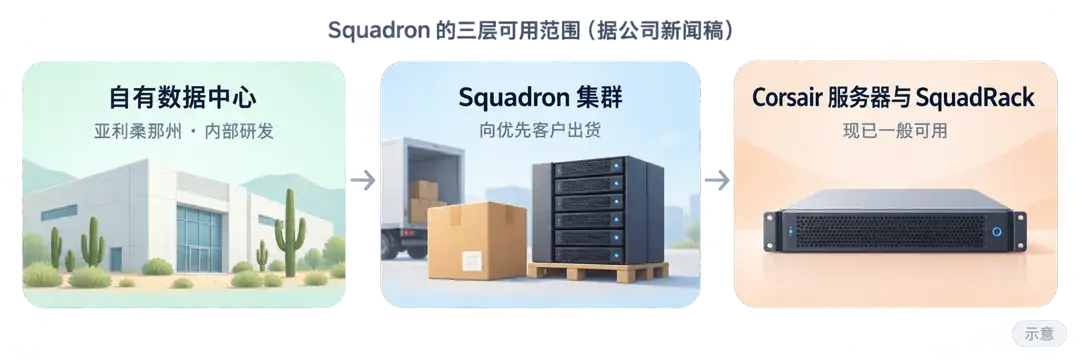
Squadron目前有三种不同的可用状态。一是它已经部署在d-Matrix位于亚利桑那州的数据中心,用途是内部研发。二是完整的Squadron系统正在向优先客户出货,部署到客户自己的数据中心,新闻稿副标题称它对部分客户一般可用。三是构建模块Corsair服务器和Corsair SquadRack已经一般可用,这一层没有再加客户限定。
Squadron由d-Matrix与Arista、Broadcom、Supermicro合作开发。Sheth说:“让客户用上我们以内存为中心的计算优势,这段路正好也是d-Matrix从一家专用芯片公司变成数据中心算力基础设施公司的过程。”他还说:“Squadron在出货,Corsair服务器和SquadRack已经一般可用,不用再等了。”
三、风冷架构对准现有数据中心
新闻稿强调,Squadron是风冷、基于行业标准的架构,客户可以直接装进已经在运营的数据中心,不需要上液冷,也不用花大钱、花长时间去扩建机房。部署路径可以从一台Corsair服务器开始,也可以先买一个完整SquadRack,再扩到多机架集群,架构保持一致。
风冷不等于低功耗。产品页把单服务器入门机架标为标准密度,即10千瓦以下;4台服务器的半机架则标为超高密度,功率档是30–100千瓦。从这些档位看,客户仍要根据现场供电和散热能力安排部署,不能只看“风冷”两个字。
四、Corsair产品线从服务器延伸到机架
Corsair服务器的参考配置是一台配8张卡、16GB性能内存,也就是SRAM,带宽1200 TB/s,最多配2TB容量内存。满配SquadRack合计128GB性能内存;性能模式可运行最高1000亿参数的模型,容量模式则面向1万亿参数以上的前沿模型。
SquadRack产品页还写明,节点内用PCIe扩展;d-Matrix同时是UALink和UEC两个产业联盟的成员。这样看,Corsair并不是一张孤立的加速卡,而是从服务器、机架到跨机架集群的一条产品线。
五、AFD把专家层固定在Corsair内存里
Sheth在主题演讲中同时公布了注意力–前馈网络拆分,也就是AFD演示。Squadron既可以只用Corsair跑完整模型,也可以让GPU和XPU各自承担一部分工作,公司把这种异构方式称为分拆计算。公司称,AFD过去一直停留在理论讨论,这次是业内首次在今天可以买到的真实芯片上跑起来;这是公司自己的说法,眼下它仍是一场公司演示。
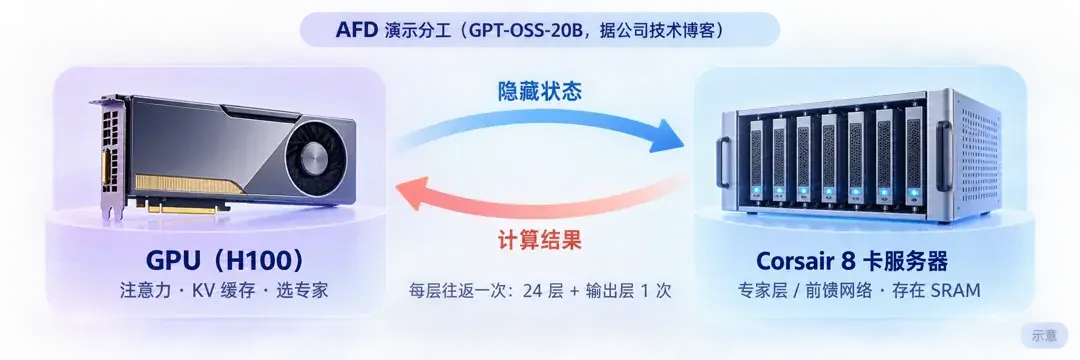
技术博客选用的是GPT-OSS-20B混合专家模型,总参数209亿,其中专家部分约191.2亿。32个专家每次只激活4个,约36亿参数;专家权重用4比特精度,正好放进一台8卡Corsair服务器的16GB SRAM。会随上下文增长的注意力和KV缓存留在GPU,大小固定的前馈网络和专家层交给Corsair。
公司解释,这样拆分是因为GPU在小批量、追求交互速度时,反复从HBM读取选中的专家权重,H100的HBM带宽约3.35 TB/s。Corsair则把专家常驻在SRAM里,公司称其带宽为150 TB/s,是H100 HBM3的45倍。这个分工把GPU留给更依赖上下文的部分,把Corsair用在固定、反复读取的专家权重上。
六、演示用的是8卡Corsair与H100组合
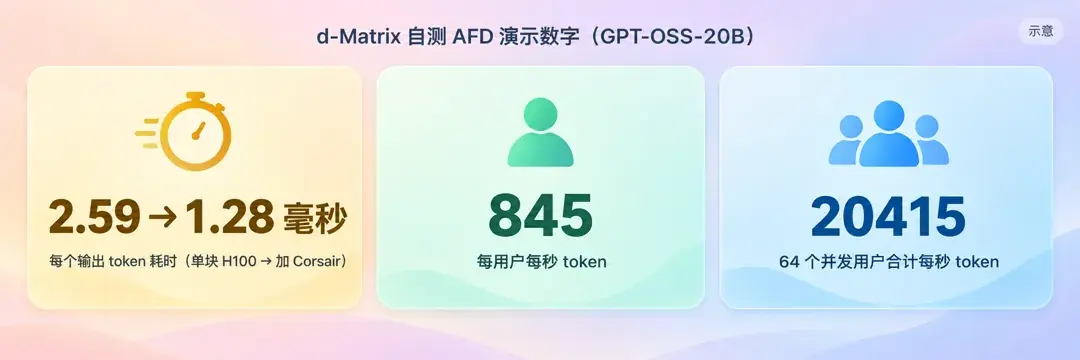
博客披露的配置并不是1024颗XPU的满配集群,而是一台8卡Corsair服务器配一到两块H100。一块80GB H100负责注意力层、KV缓存、词嵌入和选专家;批量为64时,两块H100共用这8张Corsair卡。新闻稿称,把专家层卸载到Corsair后,异构系统每个用户每秒生成845个token;64个并发用户时,合计吞吐每秒20415个token。这是公司自测数字,没有第三方复现。
延迟数据来自博客标注为10月10日的测量。上下文长度约1000个token时,单块H100单独跑GPT-OSS-20B,每个输出token耗时2.59毫秒;加入Corsair做AFD后降到1.28毫秒,公司称大约减少一半。批量64时,博客又给出一个不同工况:上下文长度为129,一整轮64用户的解码步用时2.46毫秒。
这两个吞吐数字不能直接互相推导。博客把批量1看作延迟下限,批量64则是牺牲一些交互速度去换吞吐;845是每用户速度,20415是64人合计,测试工况并不相同。通信也有成本:GPT-OSS-20B有24层,每生成一个token要在Corsair和H100之间往返24次,再加1次输出层处理。GPU发送2880维隐藏状态和目标专家,JetStream网卡的每集群带宽为400Gb/s,设备可以直接把数据写入Corsair内存,再把结果写回GPU内存,不经过主机CPU。公司称输出层处理时间缩短到原来的十分之一。研究人员将在10月14日、15日于峰会C82展台现场演示AFD。
七、下一组并排数据将继续检验AFD
博客说,后续文章会公布批量64时AFD与纯GPU配置的并排对比,这组数据是检验这条路线的下一步。d-Matrix仍是私营公司,合作方Supermicro(SMCI)、Broadcom(AVGO)、Arista(ANET)和演示所用GPU供应商NVIDIA(NVDA)均为上市公司,但新闻稿没有给出订单规模或客户名单,对这些公司的影响目前难以量化。