NVIDIA开源完整Run:ai平台,NGC社区版无企业支持
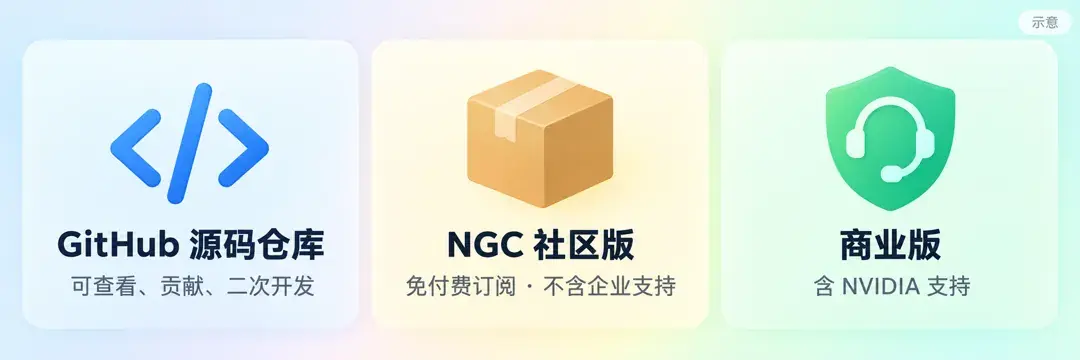
KAI Scheduler早在2025年4月1日开源,这次连配额、GPU切分和整套控制面也放进GitHub。社区版免付费订阅,可以直接安装,但下载要接受NVIDIA软件许可协议和AI产品专项条款,不含NVIDIA企业支持。
一、完整平台并入 DSX AI Factory
10月13日,NVIDIA宣布把完整的NVIDIA Run:ai平台作为开源软件发布,放进DSX AI Factory,也就是NVIDIA的AI工厂参考平台。Run:ai现在是NVIDIA旗下。NVIDIA称,它是AI工作负载和GPU编排的开放底座,提供生产级编排能力,能提高工作负载吞吐和GPU利用率,也让伙伴更快推出产品;过去几年已在Kubernetes上覆盖数据处理、训练到推理的生命周期。
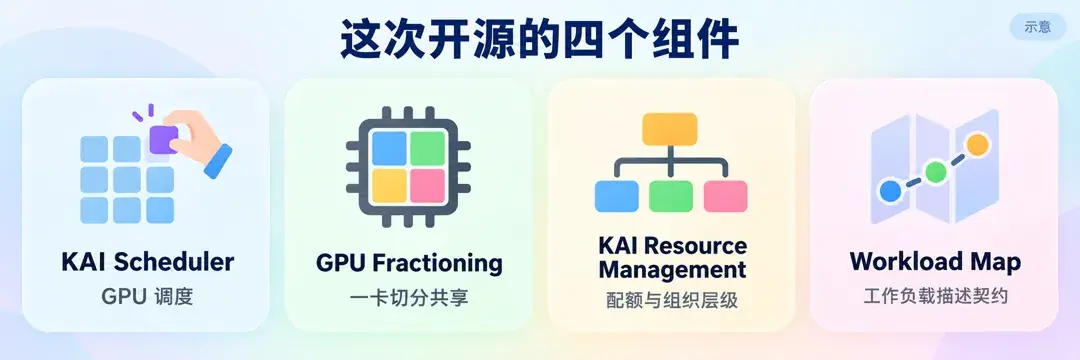
本次还放出四个可单独采用的组件:KAI Scheduler、GPU Fractioning Operator、KAI Resource Management和Workload Map。可以整套部署,在上面做自己的产品,也可以只挑一个。
二、KAI Scheduler把作业放到合适的GPU上
KAI Scheduler是Run:ai的Kubernetes原生调度器。它在2025年4月1日以Apache 2.0开源,并捐给CNCF作沙箱项目,所以这次不是新开源。NVIDIA称,所有调度器开发都在社区仓库里进行。
它支持成组调度,多Pod作业要么一起放下、要么整组不放,并先在内存里模拟;也支持公平份额、按时间的公平份额和配额。拓扑感知、装箱、MIG、MPS、时间片、HAMi、CUDA 13.4 MPS分片和DRA动态资源分配都在清单中。它能脱离完整平台,直接装进现有集群。
三、切卡、配额和任务识别各自独立
GPU Fractioning Operator把一块GPU分给多个工作负载,并做硬性显存隔离。NVIDIA称,这是机器学习团队最常用的功能之一,适合交互式开发环境和小模型推理。过去的私有实现已退役,现在改用CUDA 13.4原生GPU分片:驱动为每个工作负载设显存硬上限,各自只能看到分到的显存。Operator负责让Kubernetes用上它,还导出按Pod统计的用量指标;不绑定调度器,既能配KAI Scheduler,也兼容其他调度器。
调度器管怎么放,KAI Resource Management管谁拿多少:组织层级、GPU份额和节点池都在这里。博客举例,平台团队可以保证研究部门拿到集群50%,同时不让某个团队独占剩余容量。Workload Map则是离线运行的Go库,统一描述PyTorchJob、RayCluster、JobSet、KServe InferenceService、Dynamo图部署和自定义资源,让调度器、看板、排障、成本和备份工具识别驱动端与工作端、预填充与解码等结构。它只描述结构,不负责调度、排队、自动扩缩或跨集群分发。
四、社区版和商业版分两条路
GitHub旧的run-ai组织页写明“Run:ai已是NVIDIA的一部分”,开源项目转到DSX AI Factory组织下的dsx-ai-factory/run-ai。仓库页标的是Apache 2.0,但NVIDIA称源码受各自适用的开源许可证约束,部分组件未必是Apache 2.0;NGC上的社区版和Helm chart则要另外接受NVIDIA软件许可协议和AI产品专项条款,两者不是同一套许可。
社区版免付费订阅,不需要支持权益,但没有NVIDIA企业支持。需要企业支持的客户仍走商业版,包括独立产品、NVIDIA Mission Control、NVIDIA AI Enterprise和部分云市场;供货、许可和支持条件随产品而变。
五、八家伙伴正在集成,Lambda仍在计划
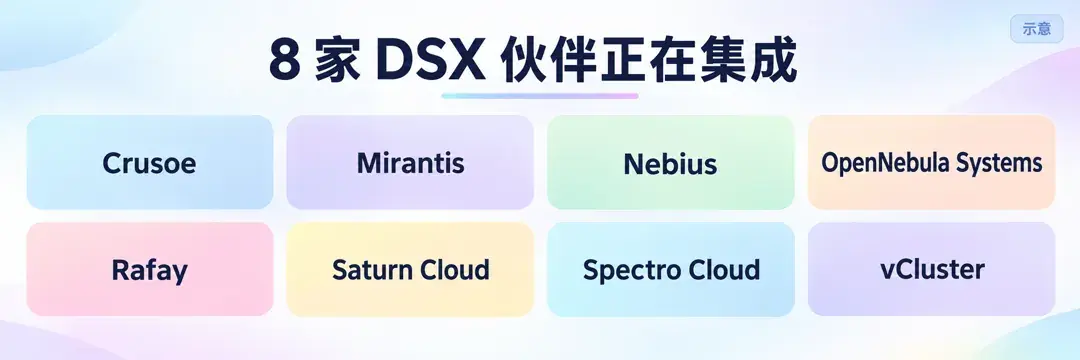
NVIDIA列出的8家DSX伙伴正在集成:Crusoe接进自家托管Kubernetes;Mirantis扩展k0rdent AI,做从裸机到模型的AI工厂栈;Nebius在Nebius AI Cloud提供一键部署应用,跑在托管Kubernetes上;OpenNebula Systems通过OneKS接进OpenNebula AI云平台,面向开放和主权AI云;Rafay做成全托管服务,放进AI云和企业的自助目录;Saturn Cloud接进Token Factory,支持白牌推理、按token计量和自动计费;Spectro Cloud接进PaletteAI;vCluster用预验证模板给每个租户一套完整环境,同时让Run:ai在同一批GPU上统一调度。博客的口径是“正在集成”,不是已经上线。
Lambda在10月13日自家博客称,自2022年起支持客户自行部署Run:ai,计划把它做成Lambda Kubernetes服务(LKS)软件库里的一等托管选项,由Lambda负责打包、验证和运维。Lambda称,开源后可以直接打包维护,而不只是给客户集成说明;上线后才可用。
六、上线方式决定开源的落点
这可能意味着,GPU编排软件会从单独收费的产品,变成DSX生态里各家AI云都能直接采用的公共底座。从生意上看,NVIDIA的回报更可能落在GPU利用率、生态黏性和带支持的商业版。对AMD ROCm生态、Slurm等其他调度方案会有什么影响,博客没有提。
接下来只看一个点:8家伙伴和Lambda什么时候真正上线,以及上线后用的是开源社区版还是带支持的商业版。这个答案将决定Run:ai是各家AI云的标准底座,还是主要给NVIDIA商业版引流。