Anthropic称Scion迁离git,日合并超3万且不对外
Anthropic在10月13日的工程博客里称,写代码已不再是瓶颈。Claude持续产出代码,压力转到了为人类规模设计的版本控制、构建和CI上。
一、合并量持续上升
博客称,5月日均合并约2500次代码变更,到9月每天超过3万次,增长十倍以上。博客配图注写明,9月9日合并30401次。每去掉一个瓶颈,代码产出就会跟上,新的压力随即出现。它也坦言,自家的负载很不寻常,很多组织近期未必会遇到。
二、完整克隆变得太重
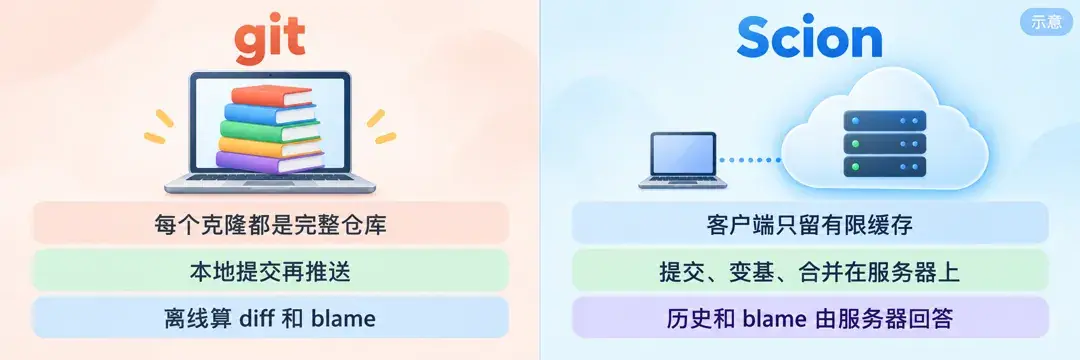
git按分布式设计,每份完整克隆都有全仓库,可以离线算差异、查历史、追溯代码作者。对绝大多数仓库,这很合适。
但博客称,自家主干历史接近100GB,压缩工作副本超过25GB;光CI每天就检出约2500万次。若每次都全量拉取,每天会产生600PB以上流量。浅克隆、稀疏检出、内部镜像和快照都用过,高峰时还运营着几百个内部镜像。这争取了时间,却渐渐撑不住:快照追不上主干,历史查询更费劲,镜像撞上磁盘和内存上限。
三、客户端默认一直在线
博客称,他们其实一直把git当成只有一份权威副本的集中式系统在用,客户端又几乎全是本来就在线的agent和任务。Scion由此围绕一台总能连上的服务器来设计:客户端管工作文件和有上限的缓存,服务器管提交、变基、合并和历史查询。客户端自己几乎算不了什么,换来的是本地少存很多数据。
所有查询都通过接口开放,许多任务直接调用,连工作副本也不需要。博客称,内部自动二分定位和回滚流水线要做大,离不开这种便宜的程序化访问。
四、提交只记录增量改动
按博客介绍,Scion的工作单位是变更集。git提交指向整棵目录树,它则记录相对第一个父提交改了哪些文件,再用内容寻址指针指向压缩文件内容。创建后立即可见,没有推送这一步,也不用为创建变更集加锁或跨服务器协调,目标是让成本跟改动大小走。
文件内容放在对象存储里,服务器也没有一份完整展开的仓库,各组件独立扩容。查历史和逐行追溯,则靠从父提交递推的派生数据,可以提前算,也能用时再算。客户端不管内部结构,服务器优化时不必跟着改。
五、检出沿三层缓存取数据
按博客介绍,scn检出时不先报自己已有多少数据,只说要哪些目录树和文件。本地缺什么就逐层请求什么,不要的目录直接跳过。文件可以被读到时才落盘,任务只为真正读的部分付费。数据按内容寻址、写入后不再变,任何缓存都能直接答,不必互相确认。
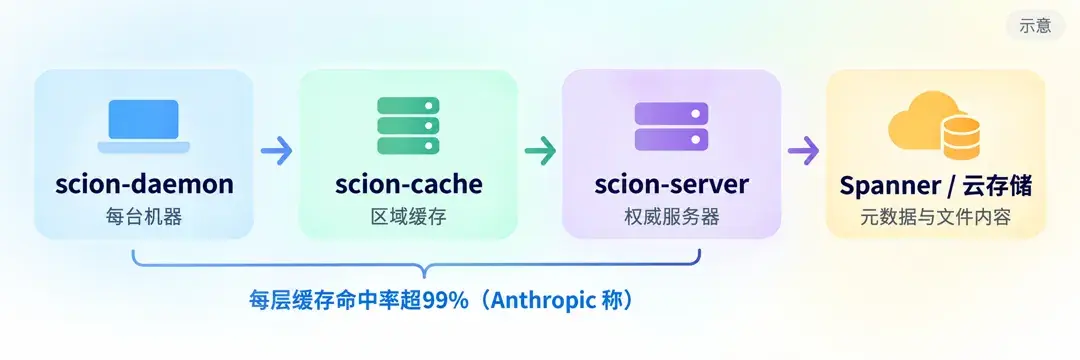
取数经过三层:节点守护进程给整台机器复用对象,只问本区域缓存;区域缺对象才找权威服务器,后者再读Spanner或云存储。区域缓存直接从内存流式发送,不算客户端缺什么,也不做差量压缩。严格分层,避免区域故障把上游压垮。
六、检出提速节省了算力
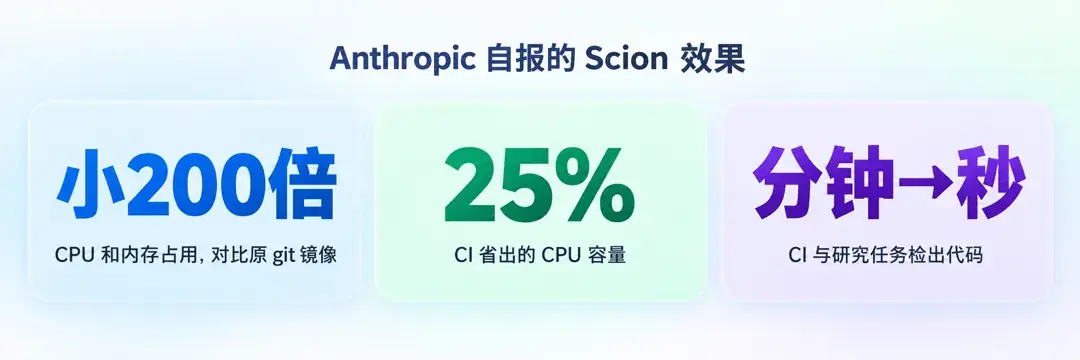
Anthropic称,每层缓存命中率都在99%以上,CPU和内存需求比原来的git镜像设施小200倍。CI和研究任务检出从几分钟缩到几秒,快了两个数量级,光CI就省出25%的CPU容量。客户端和缓存也不用再做仓库维护。
博客配图给出的中位耗时,开发环境拉最新代码从87秒到3.5秒,agent环境新建工作树从7.1分钟到5.1秒,CI检出从31秒到3.5秒,提交从1.4秒到1.1秒。这些数字没有第三方核实。
七、小团队仍得盯住设计
博客称,七个人用五个月做出了Scion、审查工具Antique和半打相关系统,完成全面迁移。参与工程师自评,Claude写代码比自己强;人负责跨系统的理解和取舍,也得对agent说“不”,防止它为局部方便违反核心约束。比如,查改动何时进主干,该问审查工具,不该逐行扫提交日志。团队仍审每个变更请求,但看改动意图,不再逐行读代码。
博客举了个例子:Claude Mythos Preview重写git到Scion的手工导入原型,内存占用降到二十分之一,速度快4倍,还保住了导入顺序等隐含约束。
八、Scion不做通用替代
Anthropic称,Scion不适合作为git的通用替代。它借鉴了Google的Piper和Meta的Sapling这两个先例,只面向真正巨大的单体仓库,要有数万名工程师或成群的agent在写代码。迁移得连审查、代码搜索和CI一起改,内部组件又高度定制。博客称很难把它做成对别家普遍有用的形式,也担心硬做一个讨好所有人的公开版本并不实用,所以Scion目前没有对外提供。
博客称,内部能投入的模型用量远超其他企业愿意投入的程度,既为开发,也为测试Claude的能力。
九、接下来看托管平台的动作
Anthropic表示希望和GitHub、GitLab及开源社区合作,这是意向,不是已签约。接下来要看git托管平台会不会补齐服务端接口、改进协商协议,并让稀疏检出和浅克隆更好配合。