
NVIDIA推出cuPotential早期访问,Lam等被列为芯片制造采用方
NVIDIA 10月14日发布新闻稿,推出处于早期访问阶段的cuPotential,也列出多家芯片设计、制造和测试公司的用法与提速数字。这些数字都来自NVIDIA或合作方自述,基线各不相同。
一、cuPotential开放早期访问
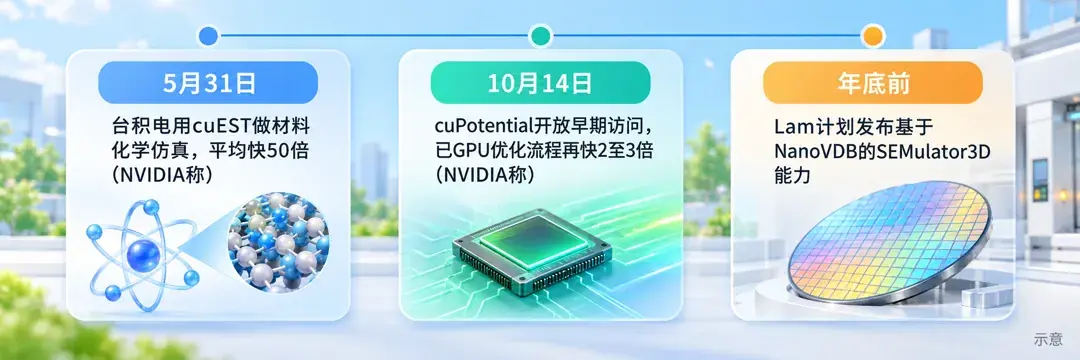
cuPotential是CUDA-X新库。开发者可把专用GPU加速函数嵌入现有软件,让AI智能体模拟原子、分子的相互作用,运行、评估并迭代分子模拟。NVIDIA称,早期访问测试让已做GPU优化的流程再提速2至3倍。Synopsys是早期采用者之一,用它加速材料仿真。
NVIDIA所称的「AI定义晶圆厂」,是AI帮工程师优化工艺、解决生产问题、提高生产效率的工厂。NVIDIA工业与计算工程副总裁兼总经理Tim Costa说,晶圆厂争相满足先进芯片需求,CUDA-X和Omniverse给智能体提供加速仿真与检测工具,帮助工程师应对复杂流程、改善良率。
二、材料与封装仿真各有结果
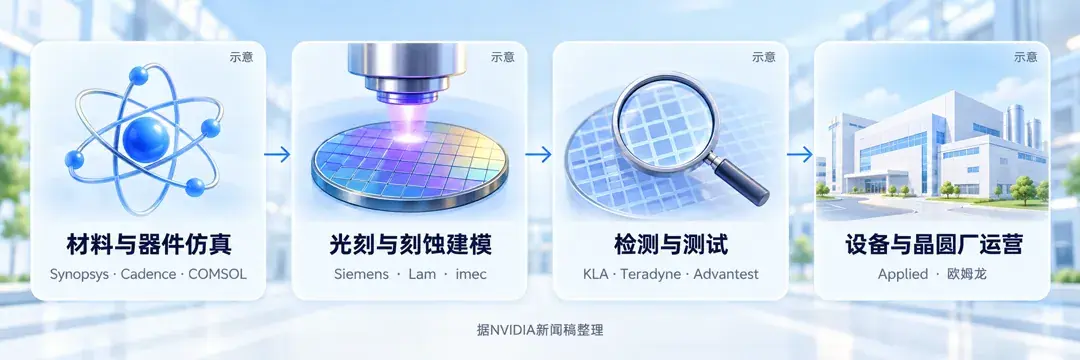
据NVIDIA新闻稿,Synopsys用cuPotential、cuEST和cuDSS加速仿真。材料计算要处理大量原子间的电作用力,NVIDIA称,这类计算即便已为GPU优化也很耗时。QuantumATK的早期结果显示,用cuEST潜在提速30倍;S-Device器件仿真基准中,cuDSS提速12倍。Synopsys的AgentEngineer还与Nemotron、NeMo互通。
Cadence的AuraStack AI Super Agent搭配Celsius和cuDSS,优化先进封装的热与应力,新闻稿称快8倍;ChipStack AI Super Agent则用Nemotron做设计与验证。COMSOL用cuDSS做仿真,NVIDIA称提速最高10倍,其计划推出的COMSOL MCP Server将用Nemotron Ultra。
Voltai的Voltaire平台处理复杂的电、热与机械仿真,公司称流程从数月压到一天,说的是整条流程耗时。ChipAgents与NVIDIA共建Build-A-Chip Bench,评估智能体从芯片规格一直到版图数据(GDS,图形数据系统)的端到端流程。
三、Lam计划在刻蚀建模里用NanoVDB
Siemens用cuLitho加速Calibre的图形修正与掩模准备,Solido团队用Nemotron和NeMo开发智能体驱动的器件表征流程。
据NVIDIA新闻稿,Lam计划把开源三维数据库NanoVDB集成进SEMulator3D,它属于Semiverse Solutions虚拟产品家族。Lam预计,部分晶圆刻蚀建模最高可提速30倍,相关能力计划今年年底前发布。NanoVDB已作为开源组件在OpenVDB中提供,Lam的集成能力仍是发布计划。新闻稿称,使用PhysicsNeMo已展示可帮助把等离子体预测仿真从数天压到最短几毫秒。
Luminary用PhysicsNeMo训练物理AI模型,预测不同封装的温度、压降和热应力。新闻稿称,工程师可在同样工期内探索多100倍的设计方案,不必为每个选项重跑仿真。这里多的是方案数量,不是运行速度。
四、检测与测试也在用GPU工具
据NVIDIA新闻稿,imec用AI给用于亚纳米测量的扫描电镜图像去噪,并用cuLitho做计算量很大的工艺窗口光学邻近校正,光刻工艺窗口改善30%。
NPP是GPU图像处理库,随NVIDIA CUDA Toolkit一起提供。KLA把自家高度优化的生产内核经验用于新的NPP NCC内核,新闻稿称其相比早期CPU版本快50倍,与KLA手工调优实现相当。Teradyne用NPP加速图像传感器测试,用RAPIDS cuDF和CuPy做GPU计算;新闻稿称,探针维护推理提速约85倍,为的是在探针劣化影响良率之前把它找出来。
Advantest将Nemotron和Kumo-Anomaly接入ACS RTDI,在Grace Blackwell系统上做实时诊断和推理,为测试单元推荐纠正措施。新闻稿称,借助NeMo Switchyard智能体,响应时间从数小时缩到数分钟。
五、Applied用数字孪生优化晶圆厂
据NVIDIA新闻稿,Applied在材料发现、工艺开发和晶圆厂优化中用Omniverse,以及cuDSS、cuEST和PhysicsNeMo,腔体仿真提速最高35倍,也用晶圆厂数字孪生优化布局与物料流。
Analog Devices把Synopsys物理仿真与Isaac Sim、Omniverse结合,做传感仿真和机器人基准。FANUC与富士康把机器人模型接入Mega Omniverse蓝图,先在工厂数字孪生里验证。欧姆龙在检测设备中用Cosmos世界模型和Metropolis视频检索与摘要蓝图开发智能体,帮工程师分析电路板检测结果、排查缺陷原因。
六、这些倍数没有统一的比较基线
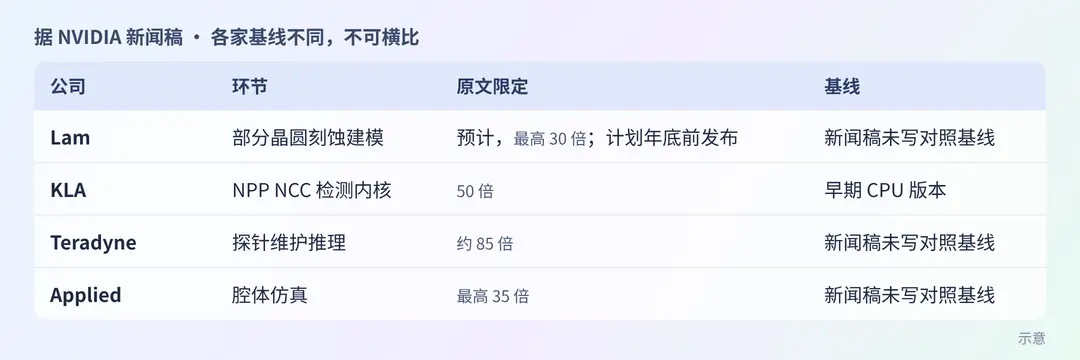
这些数都来自NVIDIA新闻稿所述公司或合作方结果,新闻稿没有提供第三方验证,也没有把各家结果放进统一基准。KLA的50倍对照早期CPU版本,cuPotential的2至3倍是在已GPU优化流程上再提速。Synopsys的30倍是早期结果中的潜在值;Lam的最高30倍带着预计、部分的限定;Luminary的100倍说的是方案数量。Teradyne约85倍和Applied最高35倍,新闻稿没写对照基线。这些数不能拿来排强弱。
这条路线此前已有铺垫。NVIDIA 5月31日在GTC Taipei发布的新闻稿称,台积电用cuEST做半导体材料设计的化学仿真,平均快50倍。这次把采用名单扩展到EDA、设备和测试厂商。
七、Lam的发布目标是今年年底
最近一个能核对的节点:Lam是否在今年年底前按计划发布基于NanoVDB的SEMulator3D能力,以及发布时怎样描述部分刻蚀建模预计最高30倍。
NVIDIA(纳斯达克代码NVDA)是发布方,新闻稿未披露收入、合同或定价。Synopsys(SNPS)、Cadence(CDNS)、Applied Materials(AMAT)、Lam Research(LRCX)、KLA(KLAC)、Teradyne(TER)和Analog Devices(ADI)在NVIDIA新闻稿中被列为采用方。采用CUDA-X库不等于GPU采购订单;按这个逻辑往外推,名单说明的是软件工具进入了哪些工作流程,还不能推到这些公司的收入变化。