AA-Robotics与Vals测语言模型控机器人,榜首不同差在时钟规则
同一时段,两家第三方评测机构都让前沿语言模型在编码代理里直接下发电机或关节指令,再看机器人能不能把活干完。两边结论大体一致,计分和时钟规则却差得很远。
一、两家第三方前后交出成绩
Artificial Analysis 在 10 月 14 日发布 AA-Robotics v0.1 研究预览;Vals AI 的 Robo-bench 页面标注 10 月 13 日更新。两份都是第三方实测,不是模型厂商自报。AA 测实体桌面臂,Vals 在 MuJoCo 里做实时物理仿真。
两榜都把两款 GPT 排在最前,但 AA 榜首是 GPT-6 Astra,Vals 榜首是 GPT-6.1 Sol。排第三的也不同,AA 是 Gemini 4 Argon,Vals 是 Claude Opus 5.5。
二、AA让模型自己交卷再判分
AA 给模型四路摄像头,桌旁三路、腕部一路。模型零样本接题,在容器里写代码并运行,通过简单 HTTP 接口控制实体六轴臂。GPT 用 Codex,Claude 用 Claude Code,Gemini 4 Argon 用 Antigravity,均开高推理档。模型自行决定何时交卷,AA 运行测试,再由人工裁判按通过标准打分,单项满分 100,没做完也可拿部分分。
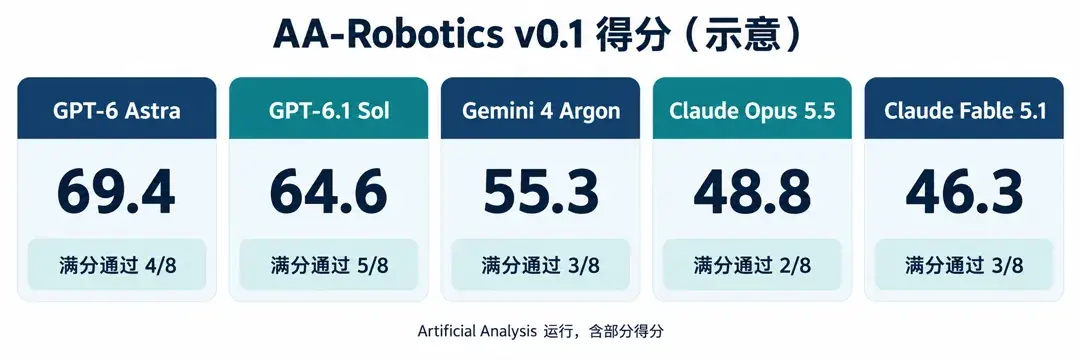
GPT-6 Astra 的 AA-Robotics 得分 69.4(满分通过 4/8 项,含部分得分);GPT-6.1 Sol 的 AA-Robotics 得分 64.6(满分通过 5/8 项,含部分得分);Gemini 4 Argon 的 AA-Robotics 得分 55.3(满分通过 3/8 项,含部分得分);Claude Opus 5.5 的 AA-Robotics 得分 48.8(满分通过 2/8 项,含部分得分);Claude Fable 5.1 的 AA-Robotics 得分 46.3(满分通过 3/8 项,含部分得分)。
八项里,按红色按钮、把鳄鱼玩具放进矩形,五个模型全过。倒饮料入杯,Astra、Gemini 满分,Sol 零分,Opus 25、Fable 30。四块积木收盒再盖盖,Sol 满分,其余多为 40 分。形状匹配,Sol、Fable 满分,Astra 44、Opus 38、Gemini 零分。写 hello world,Astra、Sol 满分,Gemini、Opus 45,Fable 零分。搭最高塔,Astra 71、Gemini 57、Opus 25,Sol、Fable 都是零分。测盒子长宽高要求误差在 2 毫米内,无模型满分,Sol、Opus 各 17 分,其余零分。
满分通过项数和总分不是一回事。Sol 多过一项,却在倒饮料和搭塔拿了零分;Astra 没过关的形状匹配和搭塔仍有部分分,平均下来反而更高。
抓住并抬起或搬运目标物的成功率,Astra 约 45%、Fable 约 44%、Opus 约 40%、Gemini 36%、Sol 28%。能抓起来和能把整项任务做完,也不是一回事。
三、Vals把机械臂和人形一起计分
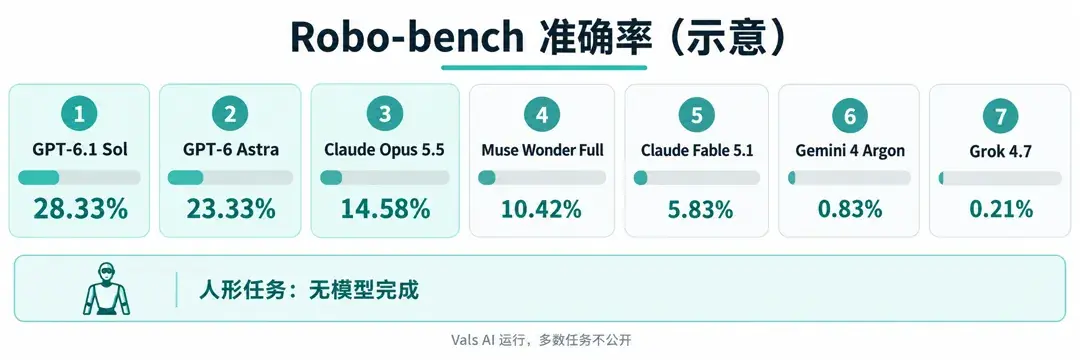
Robo-bench 测七个模型、24 项任务,机械臂 13 项、人形 11 项。公开任务只有天平配重、乐高说明书、忍者关卡三项,其余 21 项不公开。它按顺序完成的里程碑累分,单项满分 100,再把 24 项取均值报准确率,所以准确率里也包含部分得分。
GPT-6.1 Sol 的 Robo-bench 准确率 28.33%(Vals AI 运行,多数任务不公开);GPT-6 Astra 的 Robo-bench 准确率 23.33%(Vals AI 运行,多数任务不公开);Claude Opus 5.5 的 Robo-bench 准确率 14.58%(Vals AI 运行,多数任务不公开);Muse Wonder Full 的 Robo-bench 准确率 10.42%(Vals AI 运行,多数任务不公开);Claude Fable 5.1 的 Robo-bench 准确率 5.83%(Vals AI 运行,多数任务不公开);Gemini 4 Argon 的 Robo-bench 准确率 0.83%(Vals AI 运行,多数任务不公开);Grok 4.7 的 Robo-bench 准确率 0.21%(Vals AI 运行,多数任务不公开)。
Sol 在机械臂上平均约 51/100,完成其中 4 项。11 项人形任务没有任何模型完成,最高平均也不超过 2/100。人形的低分也一起进入总均分,机械臂子集的成绩不能代替总榜。拿到一点里程碑分数,也不等于完成整项任务。Muse Wonder Full 没有参加 AA 测试。
四、三分钟回合把思考也算进去
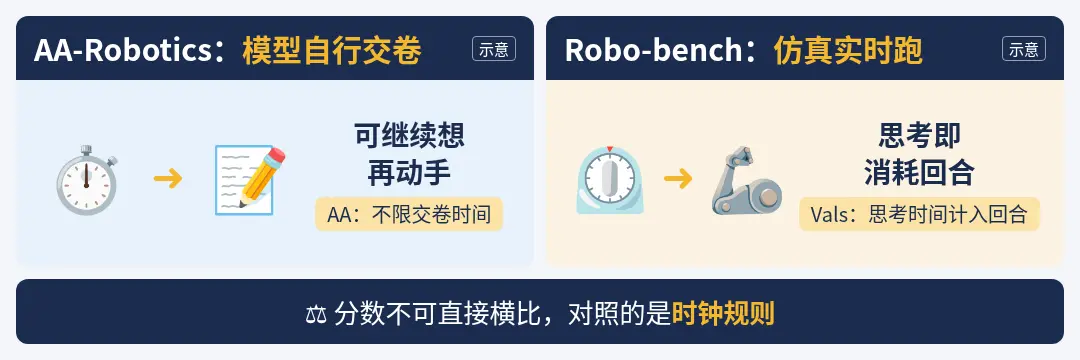
Vals 每局只有三分钟墙钟,没有准备时间。模型只拿到数据手册、运动学模型、传感器与摄像头信息;读题和观察时,仿真已经实时往前跑。机械臂没有运动规划或抓取软件,指令最高每秒 50 次;人形不配平衡或行走控制器。各代理框架均开最高推理档,除 Codex、Claude Code、Antigravity,还包括 Grok Build、Muse Code。
结果很直白,Grok 4.7 的 24 局有 16 局没发过一条电机指令,Gemini 4 Argon 有 15 局;Opus、Fable、Muse Wonder Full 各 6 局。两款 GPT 每局都动了。
第一次下指令前,Astra 平均 74.88 秒、Sol 79.89 秒;Fable 约 124 秒、Opus 约 127 秒、Muse Wonder Full 约 134 秒,Grok 约 151 秒,Gemini 约 152 秒最长。仿真在思考时继续往前走,零指令的局等于整局没有操作。
AA 不限时,由模型自行交卷,Gemini 慢归慢仍排第三。到 Vals,想得久会直接挤掉操作时间,这比分数相减更有解释力。
五、半小时的任务仍远慢于人手
AA 称,模型单任务平均约半小时,人类约 20 秒,约慢百倍;最具性价比模型的成本,也约为人工的十倍。人工基准按美国劳工统计局 2026 年 9 月数据初值,全美私营非农平均时薪 37.81 美元计算。四个模型每项约 30 分钟,Gemini 约 52 分钟,动手前观察和推理就约 21 分钟,接近其他模型两倍。
Sol 每任务平均 1.93 美元,Astra 为 16.36 美元,花费是前者的八倍多,得分只高 4.8 分。约七成花费在输入上下文。
Vals 整轮 24 项的估算 API 成本,Sol 4.97 美元、Astra 28.48 美元、Opus 11.38 美元、Muse Wonder Full 19.68 美元、Fable 20.40 美元、Gemini 17.33 美元、Grok 11.25 美元。这是整轮账单,不能和 AA 的单任务成本直接比。
六、两套分数不能共用一把尺
AA 用 Hiwonder NexArm 实体六轴臂,五关节加夹爪;Vals 用 Franka Emika Panda 七自由度机械臂和 Unitree G1 二十九自由度人形仿真,含双手。这些只是测试平台,任务、硬件、计分和时钟都不同,69.4 与 28.33% 没有可相减的共同尺度。
AA 还只是 v0.1,五个模型、八项任务。Vals 每模型每任务只跑一种子,重跑总分最多可差约十分,小差距不显著;多数任务不公开,外部也难逐项核对。两榜能对照排序和机制,不能凑出一个总冠军。
七、后续版本仍要核对时间差
AA 称,眼下这些模型太慢、太贵,单独用于生产机器人并不合适,但预计会快速变化。下一次更新,再核对单任务平均半小时与人类约 20 秒的差距有没有明显收窄。