Meta发布Muse Spark Open:8160亿开放权重附商用条件
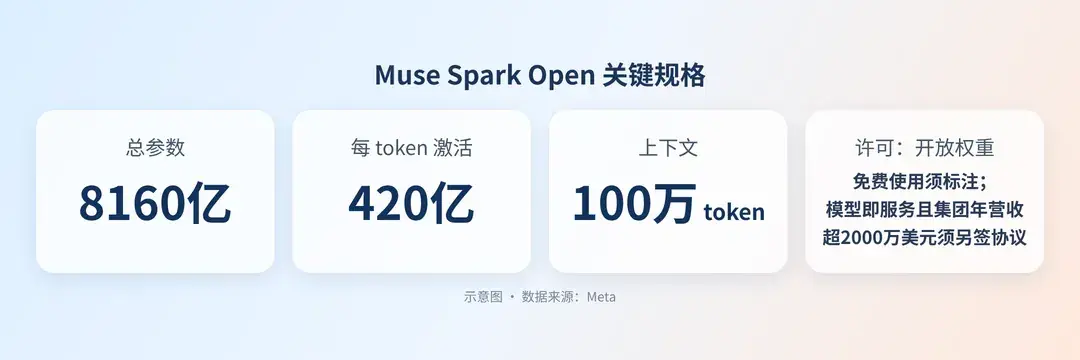
Meta 给大型编码代理增加了本地部署的选择:2026年10月15日发布的 Muse Spark Open,总参数8160亿,每个词元激活420亿。权重能免费用,但商用并非毫无条件:集团及关联方在任一连续12个月总营收超过2000万美元的模型即服务商,须在提供服务前通知 Meta 并另签协议。
一、模型面向编码和长程代理
它采用混合专家架构(MoE),模型卡列出62层、256个专家、每个词元选8个,原生支持多模态,上下文为100万词元。模型可以接收文字、图片、音频和视频,输出仍是文字,训练数据覆盖100多种语言。它的目标包括编写和调试代码,以及持续规划、调用工具、失败后重试,把多步骤工作接起来。多模态输入在这里服务于任务执行,不代表模型也能生成图片或视频。
权重提供 BF16 和 NVFP4 两版,放在 Hugging Face 门控仓库 `meta-models/Muse-Spark-Open-816B-A42B`,量化版仓库名末尾加 `-NVFP4`。下载需要申请访问权限,拿到权重后可以自行部署和修改。Meta称,它可在 SGLang、vLLM、TensorRT-LLM、Hugging Face Transformers、MLX、llama.cpp 和 Unsloth 上运行,并针对 AMD、苹果、英特尔和 NVIDIA 芯片做了优化;继续微调可用 PyTorch 的 TorchTitan。
二、强项来自 Meta 自报
Meta称,它是“迄今最强的美国开放权重模型”,这个说法有明确的地域范围。同一张对比表里,若干非美国开放权重模型在 AA Intelligence Index 和 Terminal-Bench 2.1 上更高,前者的对比成绩最高到45。
在 xhigh 推理档位,Meta自报 Artificial Analysis Intelligence Index 39、JobBench 61.8、MCP-Atlas 89.2、OSWorld-Verified 80.4;Meta自报 HLE(带工具)61.0、GPQA Diamond 89.0、Terminal-Bench 2.1 为76.4、DeepSWE 1.1 为60。这些是厂商评测,不是独立复测。代理类项目上的成绩,也不能替代对具体编码任务的检验。
三、安全成绩有测试边界
模型卡中,Meta自报内部网络滥用越狱测试拒答率99.2%,BioTIER 有害请求拒答率超过98%,MASK 诚实率98.1%;在多项公开网络安全基准上的合计拒答率为94.8%,Agentic Misalignment 测试的不当行为率为0%。这些比例对应发布版本和受测条件,不是所有下游场景的安全保证。模型卡提醒,修改模型可能削弱安全表现;实际接入工具、执行代码时,仍需要系统级防护,不能只靠模型自己拒答。
四、两台 Mac 可以装下整模
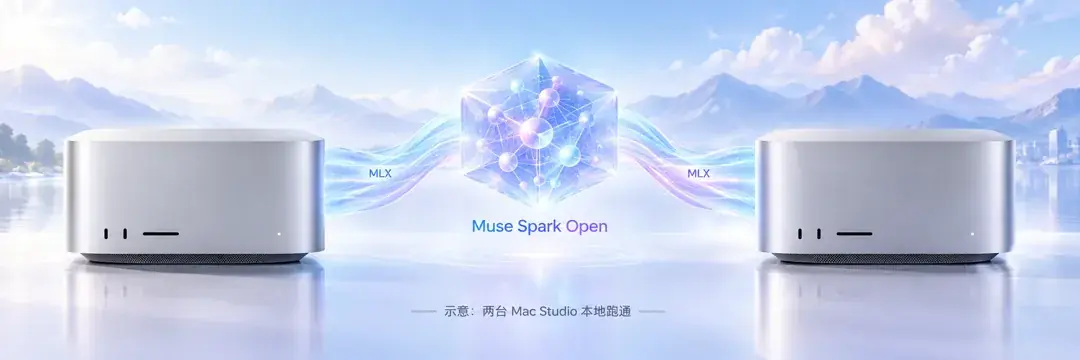
Meta称,配合苹果 MLX 框架,整模可以在两台 M5 Ultra Mac Studio 上本地运行。每台最高512吉字节统一内存,内存带宽每秒1.2太字节,两台合起来约有1太字节统一内存。每个词元只激活420亿参数,不代表整机只需装载420亿参数:模型卡写明,用GPU自行部署时,NVFP4版至少需要700GB显存,BF16版需要2TB。
Meta 的演示包括让 Muse Code 修改 Ice Cubes 的 iOS 应用、修错并完成构建,也包括驱动达芬奇调色软件 DaVinci Resolve,逐帧挑选素材并裁成竖屏。这展示了本地代理能跑通哪些流程,不能直接当作所有实际任务的速度和稳定性证明。
五、本地运行仍有硬件门槛
据CNBC,用户需要配对两到四台 Mac Studio,比 Meta 演示的两台区间更宽;M5 Ultra 的256吉字节配置起价10799美元,512吉字节版预计10月稍后推出。两台运行的方案对应高内存配置,不能理解成随便买两台就够用。本地运行减少了对云端的依赖,却没有消除硬件投入。
据CNBC,这是苹果与 Meta 罕见的公开协作,双方已经合作数月,但没有说明是否会进一步扩大关系。目前公布的合作内容,是把 Mac Studio 用作本地大模型推理硬件。
六、云端也有现成入口
不买机器也能接入。API 提供方包括 Baseten、Fireworks AI、Groq、Modal、Nebius、OpenRouter、Together AI;权重渠道包括 SageMaker AI、Google Cloud Model Garden、Hugging Face、Microsoft Foundry。调用托管接口和下载权重自行运行,是两种不同的部署选择。
部署优化要分清局部和整体。Helion 内核已进入 SGLang;Meta称在 NVIDIA 与 AMD GPU 上,内核级速度达到原来的1.03—3.95倍,但在 AMD MI350 上,端到端提速为3%。前一组数字不能直接套给整个应用,更不能当作每次代理任务的加速幅度。
七、免费许可附带条件
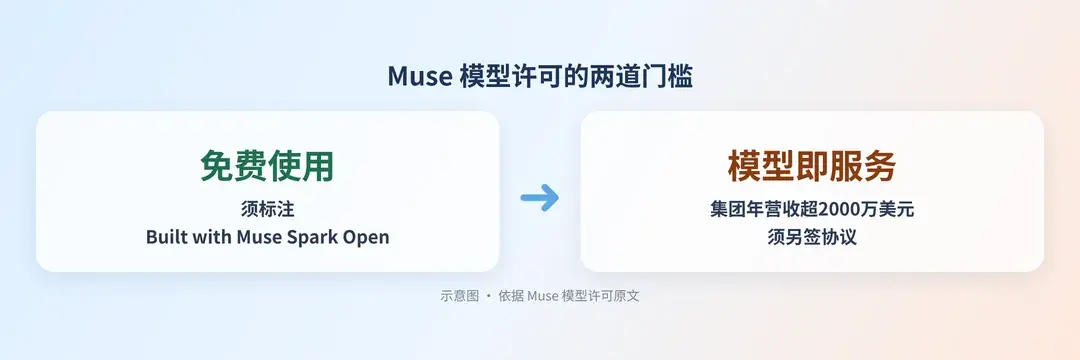
Muse 模型许可允许免费使用,但须在产品界面或文档等位置显著标注“Built with Muse Spark Open”。若以模型即服务对外提供模型,且集团在过去任一连续12个月的总营收超过2000万美元,就须通知 Meta,并在提供该服务前另签书面协议。门槛看的是公司及关联方的总营收,不只是这款模型赚了多少钱。许可同时写明,Meta 不主张模型输出的所有权,使用仍须遵守附带的使用政策。
内部使用、研究和非模型即服务的商业活动,不受这条营收门槛约束,其他许可义务仍然适用。这是定制许可下的开放权重;8月发布的300亿参数 Muse Glimmer 在 Hugging Face 上标注的则是 Apache 2.0,两者不能混为一谈。
八、落地成本要按成功任务算
据CNBC,Wang 称这些并不是 Meta 已开发或发布的最强模型;CNBC 指出,10月15日当周早些时候推出的闭源 Muse Wonder 更先进。Wang 预计,会有不少公司和开发者先小规模试用,再扩大使用规模。
这条链路里,META 是模型发布方,AAPL 只对应本地推理硬件,AMZN、GOOGL、MSFT、NBIS 对应渠道与推理服务。判断后续落地,只用一个尺度:在相同真实任务、相同完成质量下,每次成功交付的总成本。把硬件、托管和重试都算进去,再比较本地与云端,才不会把免费权重误当成免费运行。