微软MAI-Base-2完成预训练:2.8万亿参数、原生视觉,拟经Foundry授权权重
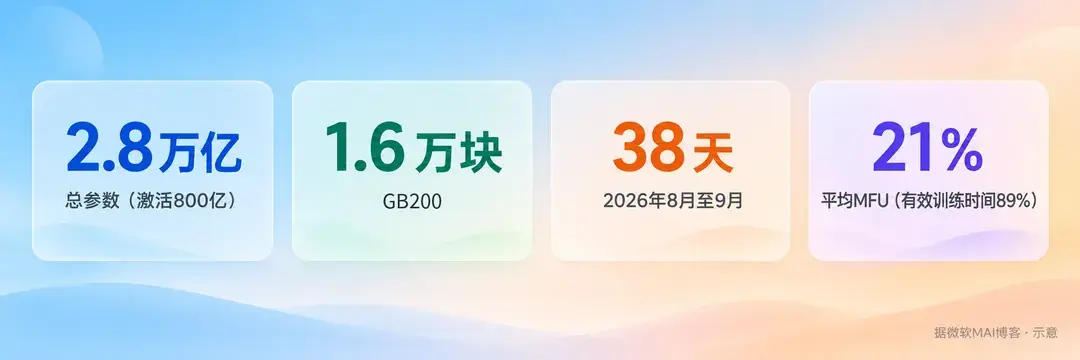
微软的自研基座又扩大一档,但这次公布的仍是训练进展,还不是可用产品。2026年10月15日,微软 AI 部门(MAI)宣布:MAI-Base-2 总参数2.8万亿、激活800亿,在1.6万块 GB200 上训练38天,平均模型算力利用率(MFU)21%。MAI 负责人 Mustafa Suleyman 当天在 X 上称,MAI 已有完全自研的3万亿参数量级预训练基座模型,后训练结果预计随后公布。
一、模型从1万亿扩到2.8万亿
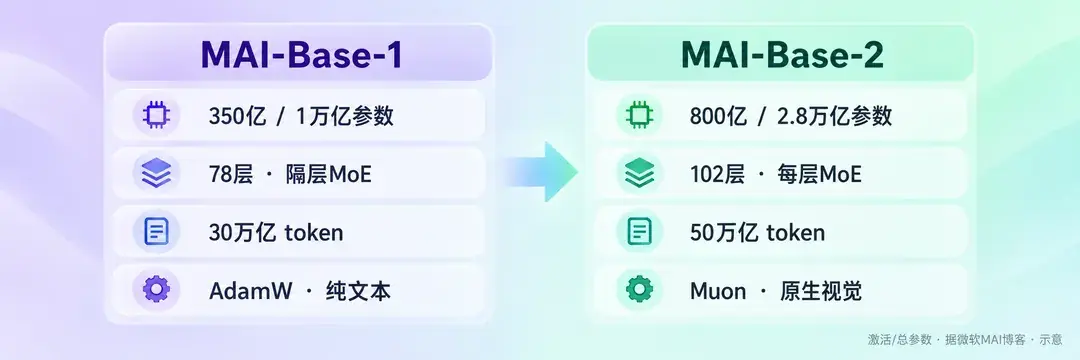
上一代 MAI-Base-1 总参数1万亿、激活350亿,2026年6月发布的 MAI-Thinking-1 就在它上面做后训练。微软称,上一代就尺寸而言很强,却比前沿开放权重和闭源模型小,下一步就是做大。
博客表格列出,层数从78增至102,隐藏维度从6656增至8704,嵌入参数由共享改为不共享。训练跨度也从30万亿增至50万亿 token。
二、两个利用率的分母不同
训练发生在2026年8月至9月。21%的 MFU,以 GB200 在 BF16 精度下每秒2500万亿次浮点运算的理论峰值为分母,不计重计算和优化器的运算量。
另一个89%,指训练实际在推进的时间占比。一个看算力,一个看时间,不能把两者当成同一种利用率。
三、小模型也保持数据重复率
据博客,团队用同一配方训练不同大小的模型,按层数分档,保持每个激活参数对应的训练 token 数不变。
小档实验还会限制唯一样本量:完整50万亿 token 训练里重复8次的数据,在5万亿 token 小跑里只取十分之一,仍重复8次。微软称,少了这一步,小实验容易偏爱正则不足、到大规模会过拟合的选择。
学习率和权重衰减一起扫描,因为模型对两者乘积最敏感。团队先在小模型拟合规律,到中档验证,再定下大模型的超参数。微软称,这套阶梯准确预测了最终表现,训练损失曲线全程平滑。
四、MoE 铺到每一层
上一代密集层与专家混合(MoE)层交替,这次每层都是 MoE。原先没有共享专家,从512个路由专家中选8个;现在加入1个共享专家,再从512个中选7个。
微软称,解决显存碎片和每个专家的固定开销后,MoE 层的 MFU 从24%升至35%。这是局部层的指标,不是整场训练的21%。
超出专家容量的 token 不丢弃,改用额外轮次处理,保持显存占用固定;稳态下只跑一轮。
五、优化器和梯度一起改
Muon 用于非嵌入的二维参数,其余仍用 AdamW。微软称,优化后 Muon 平均每步耗时165毫秒,占2.1%,理论最优估计为55毫秒。
全局权重梯度裁剪之外,团队在网络选定位置再裁激活梯度,减少少数异常数据把整批梯度一起压小的问题。微软称,最大实验档约有28%的算力效率收益;它还借此发现一段许可证声明被截断的代码,追查并修好了预处理流程中的错误。
六、视觉从预训练开始加入
微软称,本次仍只用「有机数据」,不蒸馏其他模型,每个 token 都在内部处理。唯一训练 token 比上一代多约36%,知识截止2026年3月。
模型从预训练起就是无编码器的视觉语言架构。视觉语言语料含4.5万亿唯一 token,算上重复,占50万亿 token 训练混合的18%,涵盖图表理解、电脑操作和读乐谱等任务。
网页由自有爬虫抓取。微软称遵守站点抓取规则,并排除违反其负责任 AI 政策或被美国贸易代表办公室列入「恶名市场」名单的来源。
七、效率倍数来自缩放拟合
微软用每字节比特数(BPB)比较预训练表现,越低越好,不受分词器差异影响。四组留出评测中,代码来自 MAI 自有代码库,理工、数学和问答由外部供应商专门制作,均对照训练数据做了去污染。
微软称,新模型在这些评测上的 BPB 低于它测过的所有开放权重模型。对照取自2026年10月前可得的前沿检查点,但评测集未公开,外界无法复现;其他三款开放权重模型只有后训练版本,博客承认这可能影响结果。
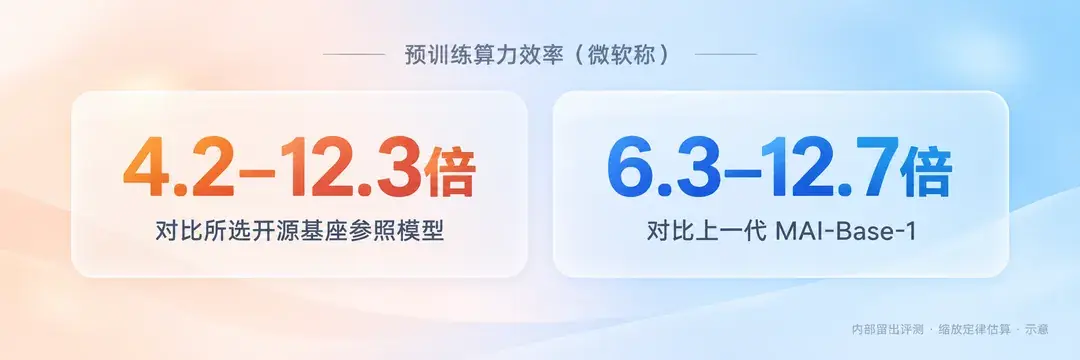
效率另算:四组评测各拟合一条 BPB 对训练算力的缩放定律,估算自家配方追平所选开源基座参照模型需要多少算力,再与参照的实际训练算力比。拟合包含本次最终结果,追平点落在拟合范围内,不是外推。
微软称,按上述基于未公开留出评测的缩放定律估算,配方相对参照的算力效率为4.2–12.3倍,相对上一代为6.3–12.7倍,并将其归因于数据质量、相关性和建模选择;对照的开放权重模型多为后训练版本。这不代表本次实际训练只用了参照几分之一的算力:博客明确说,参照的实际训练算力更少。
八、权重授权仍是计划
微软拟凭训练数据可追溯、预训练不蒸馏其他模型,经 Foundry 向受信伙伴授权权重。博客还提出,把模型和基础设施一起调优,先用于自家产品,再服务 Foundry 客户。目前模型仍在后训练,尚未发布或上架 Foundry,授权条件、伙伴名单和时间表也未公布。
九、Foundry 授权条件是落地信号
据此可以判断,微软仍在 OpenAI 之外继续加码自研前沿模型,这是推论;从业务上推测,MSFT 或增加自研模型及授权收入来源。NVDA 则对应这次1.6万块 GB200 的训练需求,同属推论。以后判断授权路线是否落地,就看 Foundry 是否给出具体授权条件。