NVIDIA发布Nemotron 3.5 Super VL与24GB本地版Bolt
10月15日,NVIDIA通过官方博客与Hugging Face,同时推出数据中心档和本地档,权重之外,还开放数据与训练配方。看点不只是模型能答多少题,而是企业能拿走哪些材料,放进自己的环境里继续训练和使用。
一、Super VL能读文字、图像和视频
NVIDIA称,Super VL总参数1200亿,每个token激活120亿,输入支持文字、图像和视频,输出文本,上下文最长100万token。它能看图、读视频,但不直接生成图像或视频。
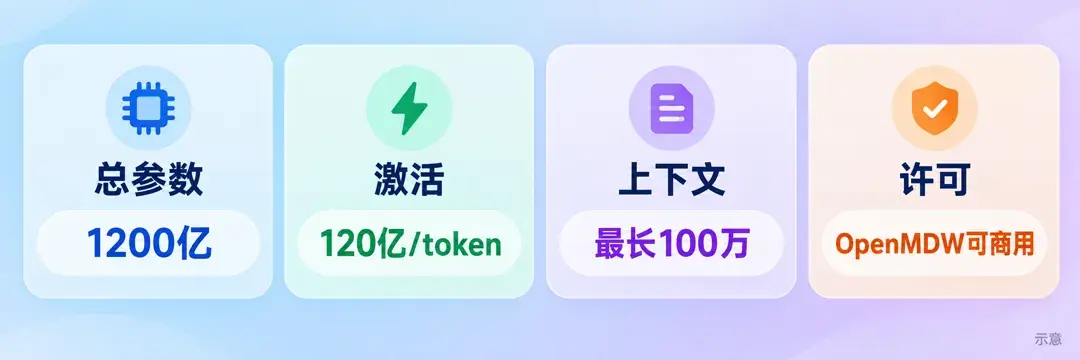
总参数和激活参数要分开看:1200亿是整套模型的规模,120亿是每个token实际动用的部分。它通过专家路由挑选部分参数工作,不是每次都让所有专家一起上场。
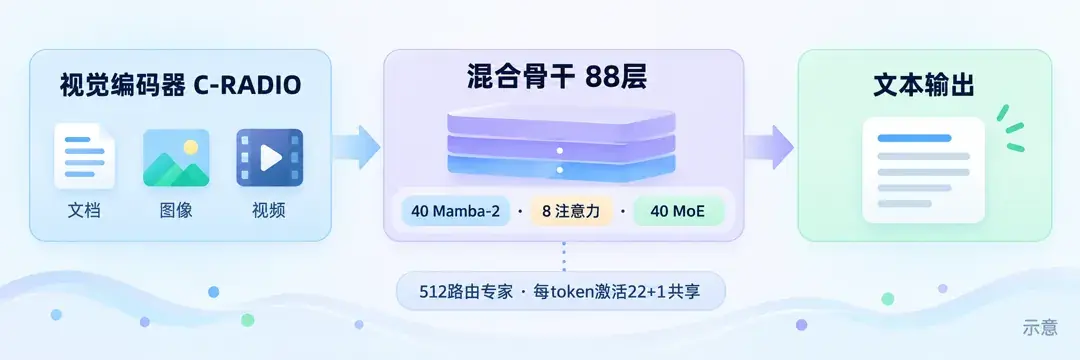
架构混合Mamba-2与Transformer,采用MoE和C-RADIO视觉编码器。88层包括40层Mamba-2、8层注意力和40层MoE;每个MoE层有512个路由专家,每个token选22个,另加1个共享专家。模型原生支持多token预测,用于投机解码;许可为OpenMDW-1.1,NVIDIA称可以商用。
二、训练把语言、代码和视觉分阶段接起来
NVIDIA称,预训练与继续预训练合计约26万亿token,后训练用了约380万样本,并覆盖数十个强化学习环境。这两个数字不是同一个口径:前者说的是训练文本量,后者说的是后训练样本数,不能混成一个训练规模来看。
语言骨干从Nemotron 3 Super Base初始化,再用Nemotron 3 Ultra Base蒸馏约1万亿token。随后扩到100万上下文,加入约670亿token的软件工程中期训练,再接视觉语言训练、监督微调和强化学习,并加强多token预测。
这条训练路线不只是给语言模型加一个看图入口。长上下文、软件工程和视觉语言都有各自的训练阶段,后面还要通过不同任务环境继续调整模型表现。
三、NVIDIA称的成绩并非样样领先
NVIDIA称,经NeMo Gym评测,GPQA-Diamond为89.52,SWE-bench Verified为71.10,Terminal-Bench 2.1为66.70;BrowseComp为78,OSWorld-Verified为51.14,HLE纯文本为31.79。
同一张对照表里,Super VL在软件工程、终端操作和tau2-bench电信等项目上,仍低于部分对照模型。它有强项,也有短板,不能把某一项成绩推广成所有代理任务都表现更好。
读这张表,适合先找自己要用的那一项。写代码、操作终端和在网页里找资料,关心的成绩并不一样。这些仍是NVIDIA称的成绩,不能替代企业拿自己的任务做验收。
四、吞吐数字要连着部署条件看
NVIDIA称,与Artificial Analysis智能指数同级模型相比,Super VL吞吐最高可达约5倍;配合Dynamo,可多服务约8倍用户,延迟降低约85%。这些数字带有比较范围,不能理解成换到任何硬件、任何任务,都能得到同样的提升。
部署也有门槛。NVIDIA建议BF16使用4张H100或2张GB200,另有NVFP4版本。这里说的是不同精度下的部署选择,不要把它们混成一个硬件要求,更不能把吞吐倍数直接套到自己的设备上。
NVIDIA称,模型已上架Hugging Face、OpenRouter、ModelScope社区,并以NIM微服务形式提供;NIM每两周更新一次安全补丁与性能优化。下载模型和把它稳定接进业务,是前后两步。
五、Bolt把本地档压进24GB
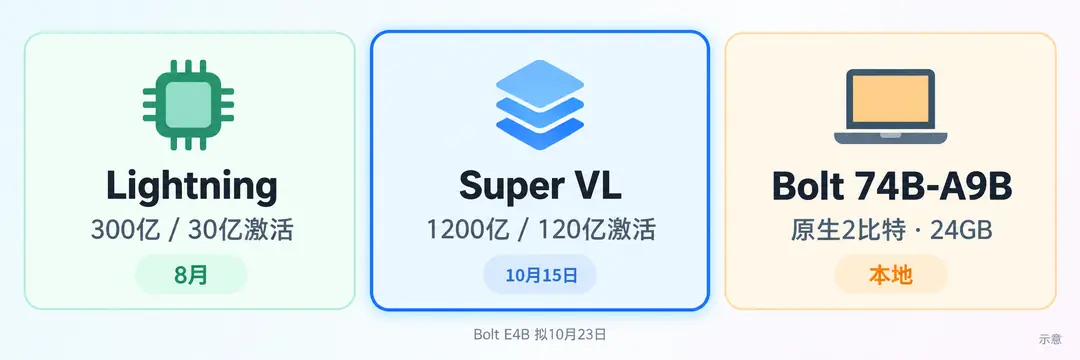
NVIDIA称,Bolt总参数740亿,每次激活90亿,靠原生2比特量化装入24GB,面向RTX与DGX Spark本地代理。它当天在Hugging Face上线,支持llama.cpp、Ollama、LM Studio、Unsloth和vLLM,用户可以沿现有工具链选择运行方式。
这里的24GB对应原生2比特量化,不能直接拿来和Super VL的BF16配置横着比。两档模型的参数规模、量化方式和部署位置都不同,不只是名字有区别。
NVIDIA称,Bolt在PinchBench同级开源模型中排第一,在BrowseComp同级开源模型中排第二;两项都是特定评测,不代表所有本地代理任务的表现。
约4GB的Bolt E4B拟10月23日上线,面向GeForce RTX、Jetson与RTX/DGX Spark上的语音助手和对话代理。家族里还有8月推出的Lightning,NVIDIA称其面向高吞吐负载,Hugging Face上的型号为300亿总参数、30亿激活;Ultra负责最难的推理任务,型号为5500亿总参数、550亿激活。
六、合作名单覆盖了不同交付环节
NVIDIA称,集成方包括Atlassian、CrowdStrike和Dassault Systèmes:Atlassian用于Jira、Confluence等应用间的代理搜索,CrowdStrike定制用于企业安全蓝队防守,Dassault用于工程设计与仿真;Perplexity用于Search与Computer产品,Salesforce通过Missionforce Operations处理政府流程,Synopsys的验证软件可与其互通。
后训练与定制侧,NVIDIA称Scale AI为Skydance的供应商信贷代理和EY的并购尽调代理做了后训练,AfterQuery为Hebbia做信贷协议分析定制,Mercor在APEX-SWE编码基准上做了后训练,Ramp则用于财务文件处理。
Together、Baseten、DeepInfra和Lambda当天在X宣布上线,属于推理商自述,可以当作服务入口的线索,不算独立核验。集成、定制、后训练和托管推理指向不同环节,被放进同一份名单,也不代表交付的是同一种产品。
七、开放材料指向软硬一体部署
NVIDIA称,视觉能力主要对准OCR、表格、图表、网页和PDF;开放数据集覆盖工具使用、金融、指令遵循、长上下文、公平性与视觉语言,NeMo Gym中的强化学习环境一并公开。
把权重、数据和配方一起开放,可以理解为降低企业在自家GPU上做后训练与私有部署的门槛。企业拿到的不只是现成模型,还有继续调整模型的材料;再接上NIM、Dynamo与DGX Spark,卖点就延伸到数据中心与桌面的软硬一体组合。
对NVDA而言,这更像是用开放模型带动GPU与软件栈使用的推论,公司未披露相关收入数字。