Claude Mythos 5设计量子电路:八项中七项Toffoli门与比特双降
论文报告,Claude Mythos 5 参与设计的八项量子电路中,七项同时减少 Toffoli 门和量子比特,DQI 解码的 Toffoli 门数降至此前构造的约1/12;椭圆曲线点加法则是新取舍,约400万个 Toffoli、935个比特,比此前最省比特的设计多用约12%比特、门数约为其1/17。
省下来的是逻辑电路设计这一层的资源,不是纠错或硬件进展。
一、研究来自 STEM Fellows 项目
Anthropic于2026年10月16日在官网介绍这项研究,相关论文 arXiv 2610.22367 第一版于10月15日提交,归入量子物理分类。Anthropic称,部分设计对已发表最佳电路的改进达到一个数量级甚至更多。研究由哈佛物理系与量子科学与工程计划的 Andi Gu 主导,Anthropic量子物理学家 Alek Kemeny 指导,合作者是哈佛的 Susanne Yelin,以及哈佛兼 QuEra 的 Mikhail Lukin。
二、评估器先验算再打分
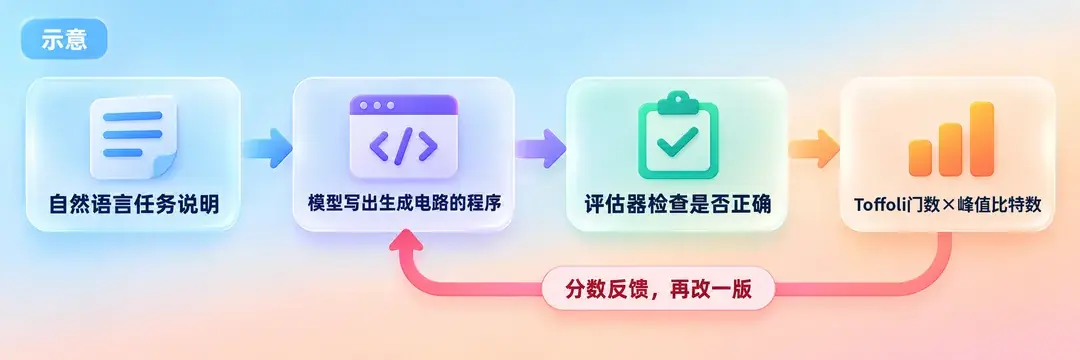
论文摘要的口径是:八项里有七项,新电路相对现有最佳同时明显减少 Toffoli 门和量子比特;第八项是素数域模逆,搜索找到一种新的可逆架构。Anthropic 博客的说法更宽,称八项都更省比特、更省门。八项任务覆盖数值计算、化学、优化、量子模拟和数论;其中 Hermitian 码 DQI 解码的对照是朴素可逆实现,并非已发表的最佳电路。模型拿到的是手写的自然语言说明,只规定电路必须算什么,不给实现思路,再从空白程序起步,用 Python 写生成电路的程序。独立评估器先检查答案、应保留的输入、辅助比特归零和相位一致性,再按“Toffoli门数×峰值量子比特数”打分,论文称为 TQ 成本,反馈随后交回模型。
博客里说的门数,论文按 Toffoli 门来数;Anthropic解释,Toffoli门开销高,数它是估算运行时间的常用办法。这类电路计算经典函数,每个输入有确定输出;论文使用的电路模型能被普通计算机高效模拟,大输入空间则用抽样核对。
三、搜索并行保留不同方案
论文使用开源 OpenEvolve,让不同算法族并行改进,定期交换好方案。每轮另开会话,模型只看到任务说明、父程序、评估反馈和有限的存档摘要。Anthropic称,早期模型偏保守,反复复核、偏好熟悉方法,因此研究者要求多方案并行,偶尔提示扩大搜索。博客称轮次之间没有人工输入,点加法那次运行的人工输入也只有最初的说明,外加偶尔提示它想得更宽。它大部分时间自己跑,关键处有人推了一把。
四、模逆少存了一串历史
据Anthropic,椭圆曲线点加法是领域常用基准,成本大头在模逆。经典 divsteps 每轮选择交换、加减或减半;做成可逆电路,朴素办法得保存一长串分支历史。Claude改从每轮之后的数对解码分支。简单规则在256位全尺寸测试中失败后,它转做数学推导,找到关键不变量和新代数恒等式,推出精确公式,再经数值模拟和 Lean 形式化验证。
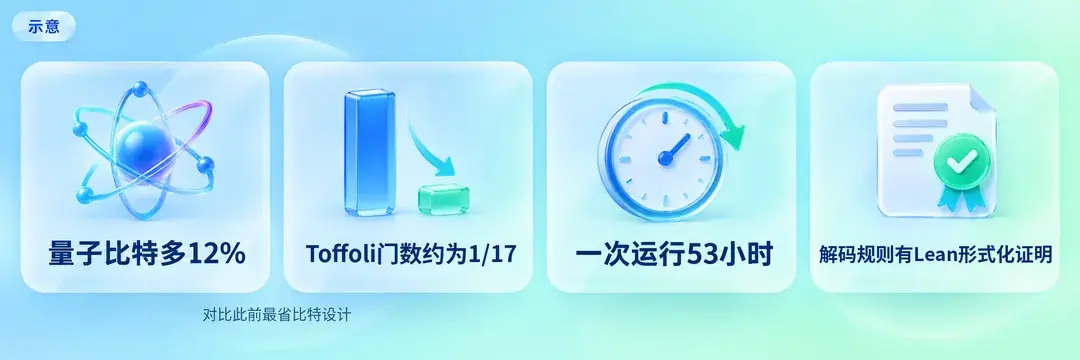
Anthropic称,一次53小时运行得到一族设计,可按阈值选择存历史还是解码。其中一个比此前最省比特方案多用12%量子比特,门数约为它的1/17。论文表S3列出的完整点加法基准电路,分别约为400万个Toffoli、935个比特,此前最省比特的 Luo 等人设计约为7000万个、838个。但 Schrottenloher 的设计只用约190万个Toffoli,需要1446个比特。这是扩展帕累托前沿的新取舍点,论文因此不报单一基线或倍数。
五、DQI 换成固定轮次算法
Anthropic把DQI,即解码量子干涉,列为可能带来超多项式加速的候选算法,其最贵一步是 Reed–Solomon 解码。据Anthropic转述Google Quantum AI团队估算,某个具体OPI问题在Frontier超算上约需3个月,在未来运行DQI的量子计算机上约需1小时,而这1小时大部分耗在解码。
Anthropic介绍,旧构造采用扩展欧几里得算法,步骤数和顺序随输入变化,电路只能按最坏情况铺开。Claude改用 Berlekamp–Massey:每轮做同类操作,轮数固定,更适合固定门序列;中间值则尽量从当前状态重建,少存历史。
六、预留空间从665减到19个比特
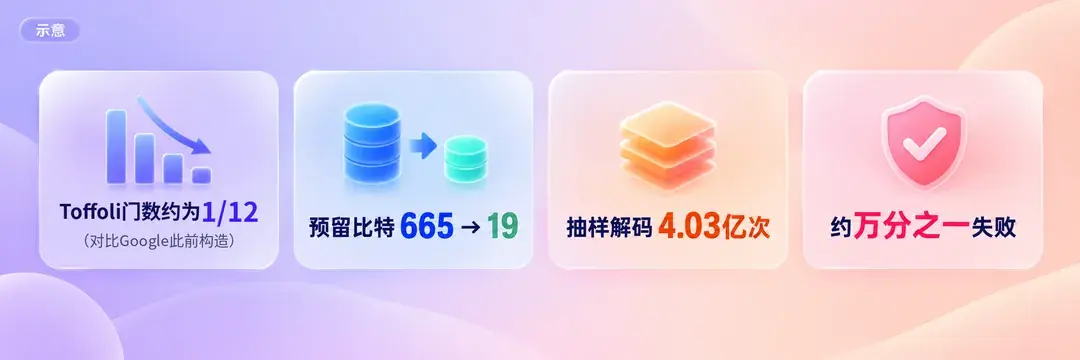
Anthropic称,少数无法重建的值若按最坏情况保存,要预留665个量子比特。模型写高速模拟器跑了4.03亿次抽样解码,发现几乎每次最多只需存一个值,于是只留19个比特。约万分之一的运行需要更多空间而失败,仍在任务容差内。
论文给出,Reed–Solomon 解码器从Google此前构造(Khattar 等人2025年论文)的约510万个Toffoli、1938个比特,降到约44万个、1837个:门数约为1/12,比特少5.2%。
七、节省仍在逻辑电路层
Anthropic援引的历史例子是FeMoco:2017年估算约需50万亿个Toffoli,多个团队用八年将其降到约3.4亿个,约15万倍,对应未来约300万个物理比特机器上的几小时计算,每步通常耗时几个月。这是此前的累积成果,53小时则是本次点加法搜索的用时。
论文也划清了范围:TQ只是一种评分,实际还要按硬件、解码器和纠错架构权衡比特数、深度、布线与测量。接口固定在计算基,陪集表示这类改变编码的优化不在框架内。Anthropic提醒,电路设计只是造出有用量子计算机的一部分,纠错码、快速解码器和硬件控制也要做到位。
八、后续要算完整算法成本
以后判断这类结果能否落地,可以盯一个口径:节省有没有写进完整算法的端到端容错资源估算,也就是总共需要多少物理比特、要跑多久。Anthropic称,更省的电路可能让实用量子计算比预期更早到来,这个判断要等端到端的账算出来才好检验。放到美股上,映射很弱也很间接:Anthropic未上市,借Google、亚马逊的投资方关系联系到GOOGL、AMZN只是推论;DQI的对照基线出自Google Quantum AI团队;IONQ、RGTI、QBTS等量子股有无影响同样只是推论,合作方QuEra也未上市。