NVIDIA 40亿参数循环模型Dory多跑几轮编码涨分,知识题几乎不动
NVIDIA在2026年10月16日发布循环模型Dory1.0-4B,同一份权重可让中间网络跑1、2或4轮。按NVIDIA对BF16版的自测,SWE-bench Verified从1轮50.3升到4轮61.8,知识类AA-Omniscience几乎不动。
一、Dory让20层共享块反复执行
它挂在Hugging Face的nvidia组织下,模型卡标注为正式版,BF16、MXFP8、NVFP4和llama.cpp用的Q5_K_M GGUF四个仓库同日创建;NVIDIA官方博客和新闻室未见Dory相关内容,也未见配套论文。模型约40亿参数,BF16权重约39.75亿,上下文最长256K,只支持英语,训练数据含43种编程语言。
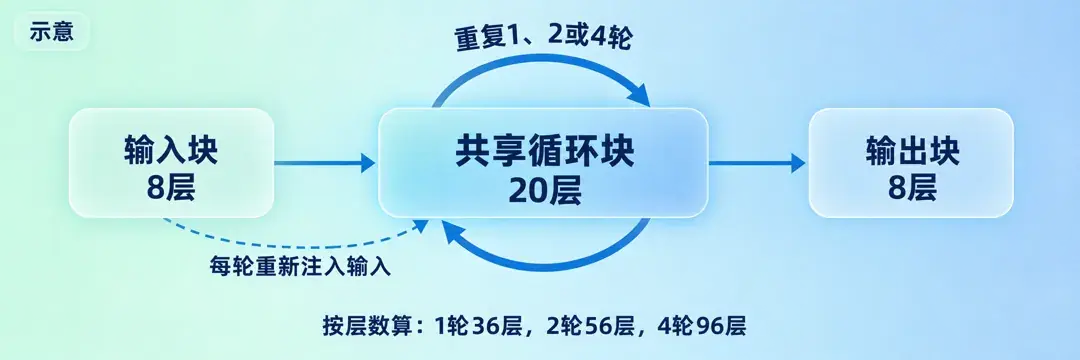
它以normalized-GPT(nGPT)为骨干,滑动窗口注意力和全注意力交错。普通堆层模型沿着不同的层往前算,Dory把36层分成8层输入块、20层共享循环块、8层输出块。中间这段能反复执行,每轮还会把输入重新注入,并非每轮另添一套参数。
二、多跑一轮就多算20层
共享块每多跑一轮,每个token多过20层;按层数算,1、2、4轮分别经过36、56、96层。前后的输入块和输出块并不跟着循环,增加的工作都在中间那段。参数量不变,改轮数无需重训或换模型。
模型卡推荐默认2轮,省算力用1轮,Terminal-Bench、SWE-bench等智能体任务可考虑4轮。模型卡还称,轮数越多,完成同一任务生成的token越少,新增计算花在隐空间里思考,而不是把输出写长;这个趋势只画在一张图上,没写出具体少多少。实际用起来,要把整个任务的等待时间和成本一起算。
三、末轮KV缓存控制显存增长
模型卡给的默认启动命令采用逐轮KV缓存,虽然每轮共用一份权重,各轮的中间结果仍分开存;多跑几轮就多留几份缓存,显存跟着涨。
把缓存模式设为末轮KV缓存后,每个循环注意力层只留一份,后一轮覆盖前一轮,缓存占用停在1轮大小。模型卡称,这样相对同规模非循环模型没有额外KV缓存开销,精度接近逐轮缓存,输出长度几乎不变。省下的是缓存空间,多轮计算仍然存在。
四、NVFP4从预训练阶段介入
6万亿token预训练用了爬取和合成的代码、数学、科学与常识数据,前约4.5万亿token原生使用NVFP4,随后改用BF16,再用3000亿token扩到256K上下文,软件是Megatron-LM。这是在预训练阶段直接用4位浮点格式,不同于训完再做权重量化。
后训练含监督微调、多环境GRPO强化学习,覆盖数学、代码和科学,也练指令遵循、多步工具调用、多轮对话与结构化输出。它采用异步强化学习,软件为NeMo RL、NeMo Gym;训练和测试数据都收集自2013年至2025年12月。
五、SWE-bench Verified涨11.5分,9.2分在第二轮
NVIDIA用NeMo Gym和NeMo Evaluator SDK完成BF16自测,未见第三方复现。以下三档依次为1、2、4轮,Terminal-Bench 2.1对所有模型统一用Terminus-2框架。
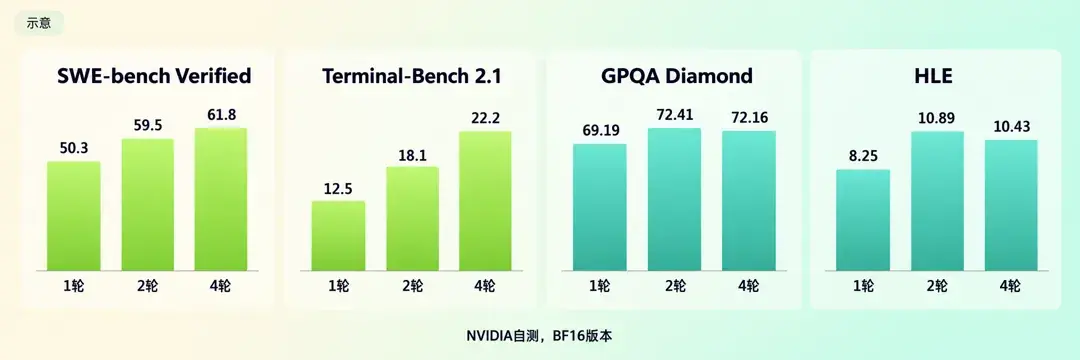
SWE-bench Verified从1轮的50.3升到2轮的59.5,再到4轮的61.8。按表计算,总涨11.5分,其中9.2分来自第二轮。从省算力的1轮换到默认的2轮,已经拿到了大部分涨分;继续加到4轮还能提高,但涨得慢了。
Terminal-Bench 2.1为12.5、18.1、22.2。GDPval-AA v2的Elo分为815、946、967。模型卡注明各项重复次数不同,GDPval和HLE只跑1次,SciCode跑8次,AA-Omniscience跑10次,AA-LCR跑16次。
指令遵循的IFBench为74.29、77.94、79。SciCode为27.3、34.94、35.11,从2轮到4轮变化已很小。银行场景τ³-bench为11.6、12.89、14.69;长上下文AA-LCR为63、71、73。
模型卡称,大部分收益来自第二轮,之后涨幅变小,提升集中在编码、智能体和指令遵循。模型卡里还有一张AA v4.3.2综合分随轮数变化的曲线,那是NVIDIA的内部估计,可能与Artificial Analysis官方分数有出入。
六、Dory的编码涨分没有带动知识题
同一张NVIDIA自测表里,无工具的GPQA Diamond为69.19、72.41、72.16;纯文本、无工具的HLE为8.25、10.89、10.43,且只跑1次。两项都是4轮比2轮略低,多跑并不保证继续涨分。
知识类AA-Omniscience准确率为10.03、10.08、10.03,三档几乎一样。这里的额外计算并没换来知识题的进步。
同表的Google Gemma 4 26B A4B也由NVIDIA用同一框架自测。SWE-bench Verified为57.40,Terminal-Bench 2.1为35。GPQA Diamond为80.43,HLE为17.79。指令遵循的IFBench为77.89,GDPval-AA v2的Elo分为751.6。知识题AA-Omniscience为21.13,SciCode为40.32,长上下文AA-LCR为64.6。
Dory的2轮和4轮在SWE-bench Verified、IFBench、GDPval-AA v2和AA-LCR上更高,在SciCode、Terminal-Bench 2.1、GPQA Diamond、HLE和知识题上更低。多跑几轮帮到了修代码,却没有把其他任务的差距一并补上。
七、权重量化已出但部署仍在分支
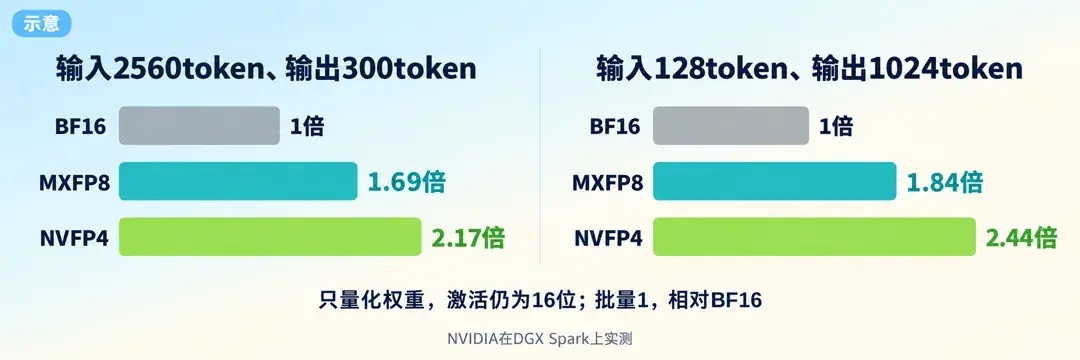
MXFP8是8位权重、16位激活(W8A16),NVFP4是4位权重、16位激活(W4A16)。两者只量化权重,激活仍以16位参与计算,NVFP4因此是4位权重,并非全4位推理。成绩表用BF16,量化版没有精度成绩。
DGX Spark实测只有两组配置,倍数均相对BF16、批量1。输入2560token、输出300token时,MXFP8速度为BF16的1.69倍,NVFP4为2.17倍;输入128token、输出1024token时,MXFP8为1.84倍,NVFP4为2.44倍。
模型卡列出的测试硬件除了DGX Spark,还有H100、B200、B300,覆盖Hopper和Blackwell,系统为Linux。llama.cpp分支可设1到4轮;苹果芯片Mac上的示例从分支源码构建llama.cpp,再加载约3.67GB的Q5_K_M GGUF导出。
vLLM合并请求#60149和llama.cpp合并请求#30306截至2026年10月18日都未合并,均未进正式版;模型卡让用户在此之前从该请求的代码安装vLLM,llama.cpp则从固定提交的分支源码构建。模型卡推荐的采样设置是温度1.0、top_p 0.95,vLLM里推理模式始终开启。许可证为OpenMDW-1.1,模型卡称可商用、可非商用。
八、编码涨幅仍待第三方复现
等vLLM支持进入正式版,再看第三方能否在SWE-bench Verified这类编码任务上复现从1轮到4轮涨十来分;判断时看两条,第三方测得的涨幅是否接近按模型卡表算出的11.5分,第二轮是否仍贡献大头。对美股NVDA,这个开源小模型本身不带来收入,更像给Blackwell的NVFP4和DGX Spark做示范,能否带动本地推理硬件需求仍只是推断。